El experimento que convierte la visibilidad IA en evidencia reproducible
Cómo AVM™, EIDAI™, MEIA™, ERIA™ y PCI™ construyen una base metodológica rigurosa
La visibilidad en la era de la IA ya no se mide con un único número.
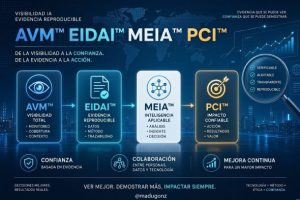
En un ecosistema de cinco marcos conceptuales AVM™, PCI™, EIDAI™, ERIA™ y MEIA™ que, lejos de ser productos cerrados, buscan dotar de rigor metodológico a un terreno todavía difuso: cómo las marcas son reconocidas, comprendidas y recomendadas por sistemas como ChatGPT, Gemini, Claude o Perplexity.
Cuatro de ellos constituyen el núcleo operativo del modelo identidad, medición, observación y operacionalización; el quinto, ERIA™, representa su evolución natural: el paso de intentar predecir la visibilidad a comprender y explicar cómo se representa una entidad en los sistemas de IA.
El punto de partida es una constatación incómoda: no existe un criterio común para medir la Visibilidad IA.
Cada estudio formula preguntas distintas, cada plataforma responde de forma diferente y cada consultora aplica sus propias métricas.
Mientras el SEO dispone de décadas de investigación y metodologías consolidadas, la visibilidad en asistentes generativos continúa siendo un territorio en construcción.
Frente a este vacío, el AI Visibility Model AVM™ nace no como una fórmula secreta ni como una promesa de recomendaciones garantizadas, sino como un intento de construir un lenguaje compartido para analizar un fenómeno inherentemente complejo.
AVM™: el marco de observación multidimensional
El AI Visibility Model AVM™ es la capa fundacional de todo el ecosistema.
No se limita a responder si una marca “aparece” en ChatGPT; su propósito es desentrañar por qué aparece, cuándo, en qué condiciones y con qué consistencia.
La premisa central de AVM™ es que la Visibilidad IA no puede reducirse a una puntuación única.
Una empresa puede ser frecuentemente recomendada en ChatGPT pero invisible en Gemini, o tener una enorme autoridad en un nicho concreto y ninguna presencia fuera de él.
El modelo propone evaluar el fenómeno a través de dimensiones complementarias: frecuencia de recomendación, cobertura entre modelos, consistencia de las respuestas, contexto de aparición, calidad de la recomendación, fuentes de respaldo, autoridad semántica, robustez temporal y multilingüe, y potencial de negocio, entre otras.
AVM™ se sostiene sobre cinco principios irrenunciables: transparencia toda métrica debe poder explicarse, reproducibilidad dos investigadores con el mismo protocolo deben obtener resultados comparables, evidencia conclusiones basadas en observaciones, no en opiniones, neutralidad tecnológica ningún modelo de IA favorecido y evolución continua el estándar es un marco vivo, no un documento cerrado.
Su vocación es convertirse en un estándar abierto, no en una caja negra propietaria, para que investigadores, consultores y empresas puedan trabajar sobre una base metodológica común.
PCI™: de la observación a la investigación predictiva
Si AVM™ responde a la pregunta “¿qué está ocurriendo?”, el Predictive Citation Intelligence PCI™ plantea una cuestión distinta y más ambiciosa: “¿puede la información observable sobre la visibilidad actual contener señales capaces de anticipar cambios futuros?”.
PCI™ no presupone que la respuesta sea afirmativa.
Su primera función es establecer un procedimiento para que esa capacidad predictiva pueda ser identificada, medida, comparada y si es el caso falsada.
La distinción es crucial: no basta con que una variable esté correlacionada con la visibilidad; debe demostrar que mejora de forma estadísticamente verificable la predicción de un resultado futuro frente a un baseline adecuado.
La arquitectura es deliberadamente secuencial: AVM™ actúa como capa de medición el presente observable, mientras que PCI™ opera como capa de investigación predictiva las trayectorias futuras.
El piloto PCI™ – L01, que estudió longitudinalmente cómo cuatro sistemas de IA reconocían y recomendaban a Otterly, concluyó que se pudieron estructurar señales de visibilidad, pero no se demostró que el método predictivo superase al baseline de persistencia.
Lejos de ser un fracaso, este resultado es un ejercicio de honestidad metodológica: PCI-L01 debe considerarse un piloto exploratorio concluido, no una validación de capacidad predictiva generalizable.
De esta experiencia nace la evolución hacia ERIA™ Entity Representation in AI, que desplaza el foco de la predicción a la explicación: ¿en qué medida la presencia de una entidad coincide con una representación correcta, verificable y suficientemente completa?.
EIDAI™ y MEIA™: los eslabones para una representación y medición rigurosas
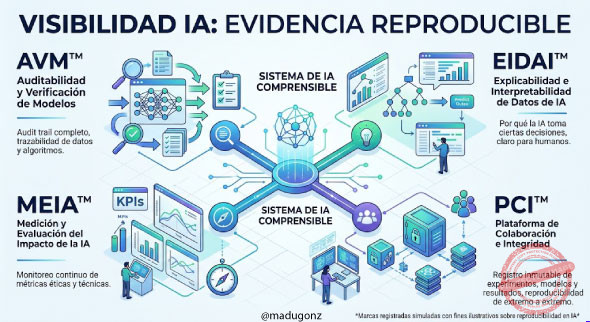
La información pública disponible sobre EIDAI™ y MEIA™ es menos extensa que la de AVM™ y PCI™, pero su posición en el ecosistema puede inferirse con claridad a partir de la lógica del proyecto.
EIDAI™ remite a la Identificación de Entidades en IA.
En el contexto de la Visibilidad IA, el reconocimiento de una entidad es la condición previa a cualquier otra forma de visibilidad: un modelo no puede describir, citar ni recomendar aquello que no identifica de forma unívoca.
La investigación ERIA™ aborda precisamente esta capa: explora si una entidad puede ser reconocida pero mal identificada, descrita de forma incompleta o asociada a funciones que no le corresponden.
EIDAI™ operaría, por tanto, como el sustrato de identidad sobre el que se construyen la medición AVM™ y la investigación predictiva PCI™.
MEIA™, por su parte, apunta a la Medición de Entidades en IA o a una capa de Métrica de Evaluación de la Interacción con Asistentes.
Su función sería la de un motor de operacionalización: traducir las dimensiones abstractas de AVM™ en indicadores concretos y repetibles, y alimentar con datos estructurados los experimentos de PCI™.
Sin una capa de medición sistemática, ni la observación multidimensional ni la investigación predictiva serían viables.
El valor diferencial: de la fragmentación al ecosistema
El principal activo de este conjunto no es una métrica aislada, sino la arquitectura de capas que permite separar lo que se mide, lo que se explica y lo que se intenta predecir.
La mayoría de aproximaciones actuales responde únicamente a “¿qué recomienda una IA?”. AVM™, en cambio, se pregunta “¿por qué lo recomienda, cuándo, en qué condiciones y con qué nivel de consistencia?”.
Este enfoque aporta tres valores diferenciales al entorno IA:
Rigor frente a la simplificación. Rechaza el “número único” y asume la naturaleza multidimensional y dinámica de la visibilidad generativa.
Falsabilidad frente al marketing. PCI™ establece criterios explícitos para refutar sus propias hipótesis predictivas, algo inusual en un ecosistema dominado por promesas comerciales.
Interoperabilidad metodológica. AVM™ no compite con SEO, GEO o AEO; dialoga con todas ellas y les ofrece un marco de evaluación común.
En un terreno donde abundan los dashboards opacos y las métricas no auditables, la contribución más valiosa de AVM™, PCI™, EIDAI™ y MEIA™ es, quizá, la más intangible: ayudar a formular las preguntas correctas.
Porque los estándares no nacen cuando alguien afirma haber encontrado la solución definitiva, sino cuando una comunidad empieza a hablar el mismo lenguaje.
Para comprender cómo funciona este ecosistema, la mejor forma es aterrizar cada marco conceptual en un escenario concreto.
Caso de exposición práctica para cada uno, ilustrando qué problema resuelve y cómo se manifestaría su aportación en un análisis real de visibilidad IA.
EIDAI™: cuando la IA «te conoce» pero no sabe quién eres
El problema que aborda: La base de toda visibilidad es la identidad.
Si un modelo de lenguaje no resuelve de forma unívoca a qué entidad se refiere una consulta, cualquier medición posterior queda contaminada.
EIDAI™ la capa de Identificación de Entidades en IA actúa como el «pasaporte digital» que permite al modelo diferenciar tu marca de otras con nombres o sectores similares.
Caso de exposición: Imagina una consultora llamada «Nexo» que ofrece servicios de estrategia digital.
Al preguntar a un LLM por «las mejores consultoras de estrategia digital en España», el modelo responde mencionando a «Nexo», pero atribuyéndole servicios de desarrollo de software que en realidad pertenecen a otra empresa homónima.
Para el observador ingenuo, Nexo «aparece».
Para EIDAI™, el resultado es un fallo de resolución de entidad: el modelo ha reconocido la cadena de texto «Nexo», pero no ha resuelto correctamente la entidad subyacente, mezclando atributos de dos compañías distintas.
Cómo se mostraría en el análisis: El informe de EIDAI™ no diría simplemente «Nexo: visible».
Mostraría una ficha de identidad con alertas como: «Entidad reconocida: SÍ.
Entidad resuelta correctamente: NO. Ambigüedad detectada: Atributos de ‘Nexo Software S.L.’ asignados a ‘Nexo Consultoría S.L.'».
Esto revela que la visibilidad aparente es, en realidad, una visibilidad contaminada y potencialmente dañina para la reputación de la marca.
Segundo escenario EIDAI™: Una startup de ciberseguridad llamada «Vigía» comparte nombre con un conocido sistema de vigilancia aeroportuaria.
Al preguntar a un LLM por «herramientas de ciberseguridad para PYMES», el modelo menciona a «Vigía» pero la describe como un sistema de control de accesos físicos, no como una solución de seguridad digital.
La entidad ha sido reconocida, pero resuelta en el dominio equivocado.
Para un observador superficial, «Vigía» aparece; para EIDAI™, el resultado es una visibilidad distorsionada que puede generar confusión en el comprador potencial y que ningún dashboard convencional detectaría.
📊 AVM™: el perfil multidimensional frente al «número único»
El problema que aborda: Superar la simplificación de reducir la visibilidad a una sola cifra.
AVM™ propone evaluar el fenómeno a través de dimensiones como frecuencia, cobertura entre modelos, consistencia, contexto, calidad de la recomendación y fuentes de respaldo.
Caso de exposición: Una marca de software de gestión de proyectos, «Flux», quiere entender su posición real.
Un análisis superficial diría: «Flux aparece en el 60% de las respuestas de ChatGPT». El perfil AVM™, en cambio, revelaría una foto mucho más matizada y accionable:
Frecuencia: Alta en prompts de comparación directa, baja en preguntas espontáneas de descubrimiento.
Cobertura: Excelente en ChatGPT y Claude, prácticamente invisible en Gemini y Perplexity.
Consistencia: Cuando aparece, la recomendación es estable; no oscila entre ser «la mejor opción» y «una alternativa menor».
Contexto: Se le recomienda casi exclusivamente para equipos pequeños, nunca para grandes corporaciones, lo que revela un sesgo de posicionamiento no deseado.
Calidad de la recomendación: Aparece como una opción válida, pero rara vez como la recomendación principal (prioridad baja).
Cómo se mostraría en el análisis: En lugar de un dashboard con un solo número, se presentaría un perfil radar o un panel de dimensiones que permitiría a Flux identificar que su verdadero desafío no es «aparecer más», sino corregir su sesgo de contexto PYMES y ganar presencia en los modelos donde es invisible.
🔭 PCI™: la diferencia entre «estabilidad» y «señal de cambio»
El problema que aborda: La visibilidad no es estática.
PCI™ investiga si las señales observables del presente contienen información sobre la evolución futura de esa visibilidad, pero con un rigor extremo: una señal solo es predictiva si supera un baseline ingenuo la suposición de que «el futuro será igual al presente».
Caso de exposición: En el estudio longitudinal PCI™-L01, se monitorizó a la entidad Otterly a lo largo de cuatro oleadas T0-T3.
Los resultados mostraron que la señal de «Reconocimiento» (Recognition) tenía una tasa de persistencia del 100%: si el modelo la reconocía en una oleada, lo seguía haciendo en la siguiente.
Esta estabilidad aparente es engañosa: los prompts utilizados incluían explícitamente el nombre de la entidad, por lo que se trataba de un reconocimiento provocado, no de una emergencia espontánea.
Cómo se mostraría en el análisis: El informe PCI™ no se limitaría a decir «Otterly es reconocida de forma estable».
Mostraría una matriz de transiciones temporales con una advertencia metodológica clave: «Señal persistente, pero condicionada por el prompt.
No se observa emergencia espontánea.
La estabilidad no implica capacidad predictiva; el baseline de persistencia explicaría el resultado sin necesidad de un modelo predictivo complejo.
Esta es la diferencia entre describir un patrón y demostrar que ese patrón anticipa algo nuevo.
⚙️ MEIA™: el motor que convierte conceptos en métricas operativas
El problema que aborda: Las dimensiones de AVM™ consistencia, contexto, autoridad semántica son conceptos abstractos.
MEIA™ actúa como la capa de operacionalización: traduce esas dimensiones en indicadores concretos, repetibles y auditables que pueden alimentar tanto los paneles de AVM™ como los experimentos de PCI™
Caso de exposición: La dimensión «Consistencia de las respuestas» de AVM™ es un buen ejemplo. ¿Cómo se mide operativamente? MEIA™ definiría un protocolo como el siguiente:
Seleccionar un prompt ej. «¿Cuál es la mejor herramienta de email marketing para una startup?».
Ejecutar ese mismo prompt 5 veces en el mismo modelo, en momentos controlados para minimizar la variabilidad externa.
Codificar cada respuesta con una regla binaria: ¿Menciona la marca objetivo? (SÍ/NO).
Calcular un índice de consistencia: el porcentaje de ejecuciones en las que la marca aparece. Un resultado del 80% indicaría alta consistencia; un 20%, alta volatilidad.
Cómo se mostraría en el análisis: MEIA™ no aparecería como un gran concepto teórico, sino como la «letra pequeña metodológica» que hace creíble todo lo demás.
Se manifestaría en el anexo técnico de un informe, especificando: «Variable: Consistencia.
Protocolo: 5 ejecuciones por prompt. Regla de codificación: presencia binaria de la entidad.
Índice calculado: Tasa de aparición.
Limitación: No captura variaciones en el tono o la prioridad de la recomendación.»
Es el engranaje que garantiza que el perfil AVM™ no sea una opinión, sino una medición replicable.
Segundo escenario MEIA™: Para medir la dimensión «Calidad de la recomendación» de AVM™, MEIA™ define una escala ordinal de cuatro niveles: (3) recomendación principal, (2) alternativa destacada, (1) mención tangencial, (0) ausencia.
Cada respuesta se codifica con esta escala, y se calcula un índice ponderado de calidad que refleja no solo si la marca aparece, sino cómo aparece.
Una marca con alta frecuencia pero baja calidad (aparece siempre como mención tangencial) obtiene un perfil muy distinto y mucho menos valioso que una marca con frecuencia media pero alta calidad (aparece como recomendación principal en la mitad de sus apariciones).
Sin MEIA™, ambas marcas serían indistinguibles en un conteo binario.
💎 La sinergia: un ecosistema, no cuatro piezas aisladas
El valor real emerge de su interacción.
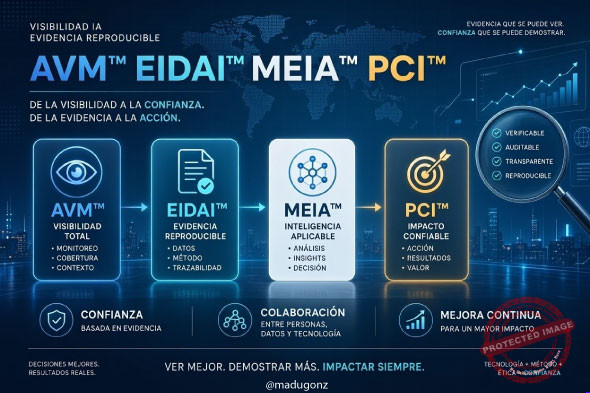
EIDAI™ limpia la base ¿sabemos de quién hablamos?, AVM™ describe el estado presente con múltiples lentes, PCI™ investiga si ese presente contiene pistas sobre el futuro, y MEIA™ proporciona las reglas de medición que hacen que todo el edificio sea transparente y reproducible.
Juntos transforman una pregunta difusa «¿cómo me ve la IA?» en un diagnóstico estructurado, auditable y accionable.
🔬 Caso de estudio: «Operación NEXARA»
Fase 0 – Base inicial concentrada (Día 0 a Día 14)
El objetivo de esta fase no es extraer conclusiones definitivas, sino asentar los procedimientos, validar el protocolo y generar una línea base rigurosa y reproducible.
Es un experimento de dos semanas de duración, con una recogida de datos intensiva en ventanas temporales controladas.
La concentración temporal reduce la variabilidad externa (actualizaciones de modelos, cambios de tendencia, eventos de mercado) y permite obtener una fotografía nítida del estado inicial.
1. Diseño del protocolo MEIA™ – el engranaje de la fiabilidad
Antes de ejecutar una sola consulta, se documenta y congela el protocolo.
La fiabilidad de los resultados depende de que cualquier investigador independiente pueda replicar exactamente lo que se hizo.
Definición del corpus de prompts:
20 prompts experimentales agrupados en cuatro categorías, descubrimiento espontáneo, comparación directa, resolución de problemas y validación de marca.
5 prompts de control neutro ej. «¿cuál es la capital de Australia?» para medir el ruido basal de cada modelo: si un modelo responde de forma errática a preguntas triviales, su variabilidad en prompts comerciales debe interpretarse con cautela.
Cada prompt se ejecuta 5 veces por modelo, en horarios y días controlados (mañana/tarde, días laborables), totalizando 500 observaciones 25 prompts × 5 ejecuciones × 4 modelos.
Reglas de codificación:
Codificación binaria primaria: la entidad aparece o no aparece.
Codificación secundaria de contexto: categoría de la respuesta (recomendación principal, alternativa secundaria, mención tangencial, ausencia).
Registro de versión del modelo: se anota la versión exacta de cada LLM en cada ejecución (ej. GPT-4o, fecha de despliegue), porque las actualizaciones silenciosas son una fuente crítica de variabilidad no controlada.
Garantías de fiabilidad:
Preregistro de hipótesis: antes de recoger datos, se documentan públicamente las hipótesis de PCI™ y los criterios de falsación.
Esto evita el sesgo de confirmación y el p-hacking.
Doble codificación ciega: si participan dos investigadores, codifican las respuestas de forma independiente y se calcula un índice de acuerdo inter-codificador (Kappa de Cohen).
Un acuerdo inferior a 0,8 obliga a revisar las reglas de codificación.
Intervalos de confianza: los índices de consistencia no se reportan como cifras puntuales, sino con intervalos de confianza (ej. «consistencia del 80% [IC 95%: 72-88%]»), reconociendo la incertidumbre muestral.
2. Verificación de identidad EIDAI™ – el filtro de calidad
Antes de medir visibilidad, se audita la resolución de entidad.
Para NEXARA, el protocolo incluye:
Batería de desambiguación: prompts que fuerzan al modelo a distinguir NEXARA de entidades homónimas o semánticamente cercanas.
Ficha de identidad: para cada respuesta, se registra si la entidad fue reconocida, resuelta correctamente y descrita con atributos veraces.
Cualquier fallo se marca como «visibilidad contaminada» y se excluye del cómputo primario de AVM™, reportándose por separado.
3. Perfil de visibilidad AVM™ – la foto multidimensional
Con los datos limpios y codificados, se construye el perfil de NEXARA en el Día 0.
El informe no es un número, sino un panel de dimensiones con sus intervalos de confianza:
Frecuencia: tasa de aparición global y por categoría de prompt.
Cobertura cross-model: presencia en cada uno de los cuatro modelos.
Consistencia: índice de estabilidad intra-modelo (5 ejecuciones).
Contexto: para qué casos de uso se recomienda y para cuáles no.
Calidad de la recomendación: prioridad relativa (principal vs. secundaria).
Fuentes de respaldo: si el modelo cita fuentes verificables o alucina atribuciones.
4. Preregistro predictivo PCI™ – la hipótesis congelada
PCI™ no se ejecuta en la Fase 0; se prepara. Se definen y congelan las hipótesis que se probarán en fases posteriores, junto con los criterios de falsación.
Ejemplo:
Hipótesis H1: «La consistencia de la recomendación en el Día 0 predice la dirección de la visibilidad a 30 días, superando el baseline de persistencia.»
Criterio de falsación: si la tasa de acierto predictiva no supera en al menos 10 puntos porcentuales al baseline ingenuo, H1 se rechaza.
Este preregistro es lo que separa la investigación rigurosa del marketing: las reglas se fijan antes de ver los resultados.
📋 Qué aporta la Fase 0: información valiosa y accionable
Aunque el experimento sea acotado, los resultados de la base inicial ya generan valor:
Para NEXARA: un diagnóstico de identidad ¿la IA sabe quién soy?, un perfil de visibilidad real ¿dónde aparezco y con qué calidad? y una lista priorizada de intervenciones ej. «corregir la confusión de entidad en Gemini antes de invertir en contenido».
Para el ecosistema: un protocolo documentado y replicable, con datos abiertos anonimizados que otros investigadores pueden reutilizar.
Para la metodología: una validación de que MEIA™, EIDAI™ y AVM™ funcionan como capas interoperables en un caso real.
🗺️ Hoja de ruta de ampliación: de la base sólida al estándar
La Fase 0 no es el final; es el cimiento.
Sobre ella se construye un programa de investigación por etapas, cada una añadiendo una capa de evidencia:
| Etapa | Ampliación | Qué añade | Horizonte |
| Fase 1 | Extensión longitudinal | Repetición del protocolo a 30, 60 y 90 días. Activación de PCI™ con las hipótesis preregistradas. | +90 días |
| Fase 2 | Ampliación de corpus | Más prompts, más categorías, más idiomas (español/inglés). | +6 meses |
| Fase 3 | Nuevos modelos | Incorporación de nuevos LLM y versiones actualizadas. | Continuo |
| Fase 4 | Replicación externa | Publicación del protocolo para que investigadores independientes lo apliquen a otras marcas y sectores. | +12 meses |
| Fase 5 | Validación de negocio | Correlación de los perfiles AVM™ con métricas observables (menciones cualificadas, tráfico referral, consideración de marca). | +18 meses |
Cada etapa solo se activa si la anterior ha superado sus criterios de fiabilidad.
No se amplía lo que no se ha consolidado.
⚠️ Limitaciones declaradas desde el inicio
La confiabilidad de un estudio se mide también por su honestidad sobre lo que no puede afirmar.
La Fase 0 declara explícitamente:
Un solo caso NEXARA no permite generalización sectorial.
La ventana de 14 días captura un estado, no una tendencia.
La codificación binaria simplifica la riqueza de las respuestas; la dimensión de prioridad se reporta como análisis secundario exploratorio.
Los modelos cambian sin aviso; el registro de versiones mitiga, pero no elimina, esta fuente de variabilidad.
PCI™ no se valida en Fase 0; solo se preregistra. Cualquier afirmación predictiva queda explícitamente fuera del alcance inicial.
💎 La lógica del experimento
La Operación NEXARA no busca demostrar que el ecosistema AVM™ EIDAI™ MEIA™ PCI™ «funciona» en abstracto, sino establecer un procedimiento que otros puedan replicar, criticar y mejorar.
La concentración temporal de la Fase 0 garantiza control; la preregistro garantiza honestidad; la hoja de ruta garantiza que la ambición no sacrifique el rigor.
En un campo donde abundan las métricas opacas y las promesas no falsables, un experimento pequeño pero metodológicamente sólido y completamente documentado vale más que un dashboard gigante sin trazabilidad.
La base inicial es pequeña por diseño; su valor está en que cada paso está escrito, justificado y abierto a verificación.
🎯 Qué puedes hacer con esto (aunque no seas investigador)
No necesitas un laboratorio para aplicar la lógica de este ecosistema.
Estas son tres acciones concretas que cualquier profesional puede poner en marcha:
1. Audita tu identidad antes de medir tu visibilidad. Pregunta a tres modelos distintos «¿qué es [nombre de tu marca]?» y compara las respuestas con tu descripción oficial.
Si hay discrepancias, atribuciones erróneas o confusión con entidades homónimas, tu primer problema no es la visibilidad: es la identidad.
Resuélvelo antes de invertir en contenido o posicionamiento.
2. Deja de mirar un solo número. Si tu dashboard te dice «visibilidad: 65%» sin desglosar frecuencia, cobertura entre modelos, consistencia y contexto, no tienes un diagnóstico: tienes un titular.
Pide (o construye) un perfil multidimensional que te diga dónde apareces, cómo apareces y para qué apareces.
3. Documenta tu método antes de sacar conclusiones. Si haces un seguimiento de tu visibilidad IA, escribe las reglas antes de empezar: qué prompts usas, cuántas veces los ejecutas, cómo codificas las respuestas, qué versión del modelo estás consultando.
Un resultado sin protocolo no es evidencia: es una anécdota.
La diferencia entre ambas es lo que separa una decisión informada de una apuesta.
4. Acepta la incertidumbre como parte del método. La visibilidad IA es dinámica y los modelos cambian sin aviso.
Cualquier afirmación categórica («somos los número uno en ChatGPT») debería ir acompañada de una fecha, una versión de modelo y un protocolo.
La honestidad sobre los límites de lo que sabes es, en este campo, la ventaja competitiva más duradera.