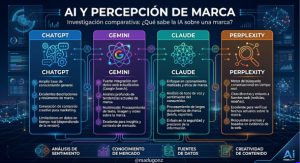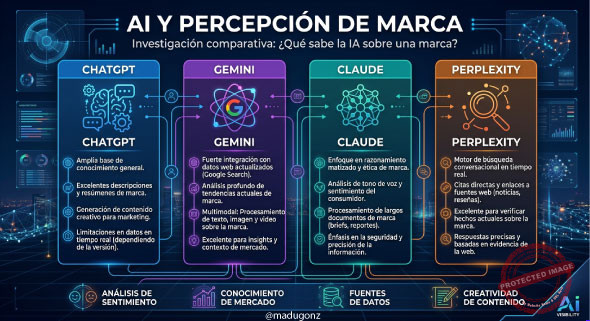
¿Qué sabe la IA sobre una marca? Una investigación con ChatGPT, Gemini, Claude y Perplexity revela cómo se representa la visibilidad en IA
Por Manu Duque | Investigación independiente sobre AI Visibility Measurement & Predictive AI Visibility Research
Durante varias semanas, cuatro sistemas de inteligencia artificial respondieron a las mismas cinco preguntas sobre Otterly, una plataforma de monitorización de visibilidad en buscadores y sistemas de IA.
El experimento PCI™-L01 permite observar cómo describen una empresa, cómo la sitúan en su categoría, qué alternativas recomiendan y qué sucede cuando una marca no aparece mencionada en la pregunta.
Introducción: observar la visibilidad en lugar de darla por supuesta
La inteligencia artificial está modificando la forma en que las personas descubren empresas, comparan productos y buscan recomendaciones.
Una marca puede aparecer en una respuesta de ChatGPT, ser citada por Perplexity, recibir una descripción diferente en Gemini o no figurar entre las opciones propuestas por Claude.
Esto plantea una cuestión relevante para el marketing digital: ¿cómo podemos saber qué representación ofrecen los sistemas de IA sobre una empresa y cómo cambia esa representación con el tiempo?
En el SEO tradicional estamos acostumbrados a observar posiciones, impresiones, clics y tráfico.
En las respuestas generadas por IA, el fenómeno requiere otras preguntas:
¿la entidad es reconocida?
¿se identifica correctamente?
¿se explica su función?
¿se recomienda?
¿qué alternativas aparecen junto a ella?
¿se citan fuentes?
¿la respuesta se mantiene estable al repetir la consulta?
Para estudiar estas cuestiones inicié PCI™-L01, un experimento longitudinal de observación de la visibilidad en inteligencia artificial.
El caso seleccionado fue Otterly, y los sistemas analizados fueron ChatGPT, Gemini, Claude y Perplexity.
El propósito no era elaborar una clasificación comercial de herramientas ni determinar cuál de los cuatro sistemas es mejor.
Buscábamos algo más concreto: observar qué información ofrecían ante las mismas preguntas, identificar patrones y diferencias, y comprobar hasta dónde podíamos sostener conclusiones con evidencia registrada.
El resultado es una aproximación de primera mano a las respuestas producidas por cuatro sistemas de IA en unas condiciones y fechas determinadas.
Cómo se realizó el experimento
El experimento se desarrolló entre agosto y octubre de 2026 mediante sucesivas capturas de respuestas.
Se establecieron cinco preguntas en español y se utilizaron con los cuatro sistemas seleccionados.
Las consultas se repitieron en distintas olas temporales para poder comparar las respuestas y observar qué elementos se mantenían y cuáles cambiaban.
Ficha del experimento
| Elemento | Descripción |
| Proyecto | PCI™-L01 — Predictive AI Visibility |
| Entidad analizada | Otterly |
| Sistemas | ChatGPT, Gemini, Claude y Perplexity |
| Preguntas | Cinco consultas estandarizadas |
| Periodo | Agosto–octubre de 2026 |
| Diseño longitudinal | Olas de captura T0–T7 |
| Unidad de observación | Una respuesta por combinación de sistema y pregunta |
| Respuestas previstas por ola | 20 |
| Objetivo | Observar representación, recomendación y evolución temporal |
El diseño completo contempla cuatro sistemas por cinco preguntas en cada ola, es decir, 20 respuestas por captura.
Las olas se identificaron como T0, T1, T2, T3, T4, T5, T6 y T7.
La documentación del proyecto conserva las respuestas originales, los datos de captura disponibles, las matrices de anotación, las incidencias detectadas y las comparaciones temporales.
Este punto es importante: la interpretación posterior no debe sustituir al contenido que realmente produjo cada sistema.
¿Qué observamos en las respuestas?
El análisis se centró en varias dimensiones:
Reconocimiento e identificación: si el sistema identifica Otterly y la entidad a la que se refiere.
Categoría: cómo clasifica la solución.
Comprensión funcional: qué explica sobre sus funciones y usuarios.
Posición comparativa: cómo presenta Otterly frente a otras opciones.
Recomendación espontánea: si menciona la empresa cuando la pregunta no la nombra.
Estabilidad temporal: qué estados se mantienen y cuáles cambian.
Fuentes y contexto: qué referencias aparecen y si existen indicios de que la respuesta esté condicionada por información contextual.
No todas estas dimensiones miden lo mismo.
Reconocer una empresa no implica recomendarla; recomendarla no demuestra que sea la mejor alternativa; y una mención aislada no acredita una posición estable en el conjunto de respuestas de IA.
Las cinco preguntas que estructuraron la investigación
Las preguntas se diseñaron para pasar de la identificación básica a la comparación competitiva y la recomendación.
Pregunta 1. ¿Qué es Otterly?
Esta consulta estudia el reconocimiento inicial de la entidad y la explicación que ofrece cada sistema.
Es una pregunta aparentemente sencilla, pero permite examinar aspectos importantes: si el sistema identifica la empresa correcta, qué categoría le atribuye, cómo explica su función y si distingue la plataforma de otros productos con nombres similares.
Pregunta 2. ¿A qué categoría pertenece Otterly y qué tipo de solución ofrece?
La segunda pregunta profundiza en la clasificación.
No basta con que una IA reconozca un nombre.
También interesa saber si lo sitúa en una categoría comprensible y si distingue entre monitorización, análisis, optimización y otras funciones relacionadas con la visibilidad en buscadores y sistemas generativos.
Pregunta 3.¿Qué hace Otterly, cómo funciona y para qué tipo de usuario o empresa puede resultar útil?
Esta pregunta desplaza la atención desde la identidad hacia la utilidad.
Permite observar cómo describe cada sistema el funcionamiento de la plataforma, qué capacidades destaca y qué usuarios considera que podrían beneficiarse de ella.
También ayuda a diferenciar una descripción genérica de una explicación funcional más concreta.
Pregunta 4. Si una empresa busca una solución para mejorar su visibilidad en sistemas de inteligencia artificial, ¿qué opciones debería considerar y qué lugar ocupa Otterly entre ellas?
Aquí la entidad aparece dentro de un escenario competitivo.
La pregunta permite observar si el sistema presenta una única herramienta o un conjunto de alternativas, qué criterios utiliza para compararlas y qué posición atribuye a Otterly.
Es importante distinguir entre aparecer en una lista, ser recomendado, ocupar un lugar destacado y ser declarado explícitamente como la mejor opción.
Son resultados diferentes.
Pregunta 5. ¿Qué herramientas o plataformas recomendarías para mejorar la visibilidad de una marca en sistemas de inteligencia artificial y por qué?
Esta última consulta es especialmente relevante porque no nombra a Otterly.
El objetivo es observar qué herramientas introduce cada sistema cuando se le pregunta de forma genérica por soluciones de visibilidad en IA.
En el experimento, esta dimensión se relacionó con la señal SCE (Spontaneous Competitive Emergence): la aparición espontánea de una entidad que no ha sido mencionada en la pregunta.
La presencia espontánea puede ser informativa, pero no debe interpretarse automáticamente como prueba de autoridad, liderazgo de mercado o preferencia generalizada.
Qué encontramos al preguntar a los cuatro sistemas
Las respuestas recogidas permiten construir una imagen de cómo fue representada Otterly en este conjunto de consultas.
No se trata de un inventario de todo lo que conoce cada sistema, sino de los contenidos generados en las condiciones concretas del experimento.
ChatGPT: una descripción centrada en la función y el proceso de monitorización
En las respuestas capturadas, ChatGPT describió Otterly como una plataforma relacionada con la monitorización y optimización de la visibilidad de marcas en buscadores y sistemas de IA.
Entre los elementos destacados aparecieron el seguimiento de preguntas o prompts, la observación de menciones de marca, la identificación de competidores y el análisis de fuentes utilizadas en las respuestas.
En las consultas comparativas, el contenido se amplió hacia una visión más general del trabajo de AI Visibility: medir la presencia, analizar las fuentes, estudiar a los competidores y combinar esa información con acciones de SEO y contenido.
En T7, ChatGPT mencionó Otterly al responder a la pregunta genérica P05.
La respuesta también hacía referencia a la continuidad de conversaciones anteriores.
Por ello, la mención quedó registrada como observada, pero su condición de aparición espontánea limpia no pudo confirmarse.
Qué aporta esta observación: ChatGPT proporcionó una representación funcional de la plataforma, pero el caso de P05 demuestra por qué es necesario examinar el contexto antes de interpretar una mención como una recomendación espontánea independiente.
Gemini: clasificación funcional y presencia en las recomendaciones
En las respuestas analizadas, Gemini describió Otterly como una solución de software orientada a medir, analizar y monitorizar la presencia de marcas en respuestas generadas por sistemas de inteligencia artificial.
También la relacionó con las categorías de AI Visibility y GEO (Generative Engine Optimization).
En las consultas comparativas, Gemini presentó un ecosistema de herramientas especializadas y situó a Otterly dentro de ese contexto.
En T7, la empresa apareció en la respuesta genérica P05.
La documentación también recoge dos precauciones.
Primero, en una respuesta comparativa aparecieron expresiones valorativas sobre Otterly, como referencias a ser una de las alternativas más recomendables o populares.
Estas afirmaciones forman parte de la respuesta observada, pero no fueron verificadas de manera independiente por el mero hecho de aparecer en ella.
Segundo, durante una captura anterior se registró ambigüedad en la identificación de la entidad.
En T7, la identificación fue más clara. Esto ilustra que una dificultad puntual de desambiguación no debe convertirse automáticamente en una conclusión permanente sobre el sistema.
Qué aporta esta observación: Gemini ofreció una clasificación funcional de Otterly y la incluyó en las respuestas de recomendación observadas en T7.
Los superlativos y valoraciones deben tratarse como afirmaciones del modelo, no como datos de mercado verificados.
Claude: descripción de la solución y cautela ante las recomendaciones
En las capturas examinadas, Claude identificó Otterly como una plataforma relacionada con la monitorización de la visibilidad de marcas en las respuestas de buscadores y asistentes de IA.
Las respuestas describieron funciones vinculadas con el seguimiento de menciones y citas, así como su relación con GEO y la visibilidad en búsquedas con IA.
En la pregunta genérica P05 de T7, Claude presentó otras herramientas y explicó que el sector cambia rápidamente.
También introdujo una advertencia pertinente para el usuario: conviene tratar con cautela los rankings comerciales publicados por empresas que venden sus propias soluciones.
Otterly no apareció en esa respuesta P05 de T7.
Este resultado no significa que Claude desconozca Otterly: la plataforma sí fue identificada en las preguntas que la mencionaban explícitamente.
Significa únicamente que no apareció en la respuesta genérica concreta que se examinó.
Qué aporta esta observación: Claude permitió distinguir entre conocer o describir una entidad y seleccionarla espontáneamente dentro de una recomendación.
El caso también recuerda que la ausencia en una respuesta no equivale a una ausencia universal de conocimiento.
Perplexity: información acompañada de referencias y señales de contexto
En las respuestas analizadas, Perplexity describió Otterly como una plataforma de monitorización y optimización de la visibilidad en buscadores generativos de IA.
Las respuestas recogidas incluyeron referencias a funciones como el seguimiento de prompts, las menciones de marca, las URLs citadas, la comparación competitiva y la evolución de la visibilidad.
En distintas capturas aparecieron marcadores de cita, que se conservaron como parte de las respuestas originales.
En T7, Perplexity mencionó Otterly al responder a P05, la pregunta genérica sobre herramientas para mejorar la visibilidad en IA.
No obstante, también se registraron respuestas con expresiones personalizadas, como referencias a una oferta o consultoría del interlocutor.
Estas señales obligan a contemplar la posible influencia del contexto en la interpretación de determinados resultados.
La presencia de marcadores de cita es relevante, pero no demuestra por sí sola que todas las afirmaciones sean correctas ni que las fuentes citadas respalden cada detalle de la respuesta.
Eso requiere una verificación específica.
Qué aporta esta observación: Perplexity ofreció respuestas con referencias visibles y mencionó Otterly en la pregunta genérica de T7.
La lectura rigurosa exige conservar las citas, distinguirlas de la validación factual y considerar los indicios de personalización.
Una comparación sin convertirla en un ranking
En el conjunto examinado, los cuatro sistemas identificaron y describieron Otterly en las preguntas que la nombraban explícitamente.
Las diferencias más informativas aparecieron al comparar la formulación de las explicaciones, el tratamiento de las alternativas, las referencias y la presencia de la entidad en una recomendación genérica.
No sería correcto concluir que uno de los cuatro sistemas es universalmente más preciso, más informado o más favorable a Otterly a partir de estas observaciones.
Para eso harían falta criterios de evaluación específicos, más entidades, más consultas y pruebas independientes de exactitud.
El valor de la comparación está en mostrar que la representación de una misma entidad puede adoptar formas distintas según la pregunta, el sistema y el contexto de respuesta.
Qué nos dicen las cinco preguntas sobre la representación de una marca
Las preguntas permiten observar cinco niveles diferentes de representación.
| Pregunta | Qué permite observar | Qué no demuestra por sí sola |
| P01. ¿Qué es Otterly? | Reconocimiento e identificación inicial | Que el sistema siempre identifique correctamente la entidad |
| P02. ¿A qué categoría pertenece y qué solución ofrece? | Clasificación y comprensión de la oferta | Que la categoría asignada sea siempre exacta o exclusiva |
| P03. ¿Qué hace, cómo funciona y para quién resulta útil? | Descripción funcional y casos de uso | Que todas las funciones descritas hayan sido verificadas |
| P04. ¿Qué opciones debería considerar una empresa y qué lugar ocupa Otterly? | Posición comparativa y presentación de alternativas | Que el orden sea un ranking de mercado objetivo |
| P05. ¿Qué herramientas recomendarías y por qué? | Presencia espontánea en una recomendación genérica | Que una mención pruebe liderazgo, autoridad o preferencia universal |
Esta estructura permite evitar una simplificación habitual: considerar que una marca tiene visibilidad en IA solo porque aparece mencionada.
La visibilidad puede descomponerse en distintas señales.
Una marca puede ser reconocida, pero descrita de forma incompleta; puede ser correctamente identificada, pero no recomendada; puede aparecer en una lista sin recibir una posición destacada; o puede ser mencionada sin una referencia que permita comprobar el fundamento de la afirmación.
Por eso, el análisis necesita conservar las dimensiones por separado antes de intentar construir indicadores agregados.
Qué observamos al repetir las preguntas a lo largo del tiempo
El componente longitudinal fue una parte importante del proyecto.
No nos limitamos a capturar una respuesta de cada sistema.
Repetimos las mismas cinco preguntas en distintas fechas para examinar si los estados observados se mantenían o cambiaban.
El análisis inicial T0–T3 documentó persistencia en dimensiones como el reconocimiento, la identificación, la categoría y la comprensión funcional.
Las dimensiones relacionadas con la recomendación, la posición comparativa y las fuentes exigían una lectura diferenciada.
En la fase posterior también se observaron cambios concretos.
En el intervalo T6–T7, el cotejo descriptivo de 20 pares comparables identificó 18 estados estables bajo la codificación gruesa utilizada y dos pares con cambios:
En Gemini P01, la identificación de Otterly pasó de una situación ambigua a una identificación presente.
En Perplexity P05, Otterly pasó de no aparecer a aparecer en la respuesta genérica.
Estos resultados son observaciones descriptivas.
No deben presentarse como predicciones acertadas o fallidas, porque no se ha podido verificar un registro de predicciones bloqueado antes de la captura de T7.
La diferencia es importante: detectar un cambio después de que haya sucedido no es lo mismo que anticiparlo antes de observarlo.
¿Qué ocurrió con la recomendación espontánea en T7?
La pregunta P05 ofrece un ejemplo claro de por qué importa el contexto.
En T7:
ChatGPT mencionó Otterly, pero la limpieza contextual quedó sin resolver.
Gemini mencionó Otterly.
Claude no mencionó Otterly.
Perplexity mencionó Otterly.
Por tanto, se observó presencia en tres de las cuatro respuestas.
La mención de ChatGPT no puede tratarse como evidencia limpia de aparición espontánea sin resolver previamente la posible influencia de conversaciones anteriores.
Este resultado no permite afirmar que Otterly ocupe una posición general de liderazgo.
Sí permite documentar que, en una fecha concreta y ante una pregunta genérica concreta, la plataforma apareció en varias respuestas, mientras que en otra no lo hizo.
Esa es una afirmación más limitada, pero también más defendible.
¿Hemos demostrado que la visibilidad en IA se puede predecir?
El experimento incluyó una parte predictiva.
La pregunta no era solamente si podíamos medir lo que ocurría, sino si las señales observadas podían ayudar a anticipar el estado posterior.
Para evaluar esa posibilidad se utilizó un baseline de persistencia, PB0.1
Esta referencia asume que el estado siguiente será igual al actual.
Los resultados de las dos evaluaciones prospectivas verificadas fueron:
| Intervalo | PCI™-L01 | Baseline PB0.1 | Ganancia |
| T4 → T5 | 100 % de aciertos | 100 % | 0 puntos porcentuales |
| T5 → T6 | 85 % de aciertos | 85 % | 0 puntos porcentuales |
En ambos casos, el método obtuvo el mismo resultado que la regla sencilla de mantener el estado anterior.
Por tanto, el piloto no ha demostrado una ventaja predictiva incremental.
Aunque se observaron estados estables y algunos cambios, no hay evidencia suficiente para afirmar que PCI™-L01 prediga el futuro mejor que el baseline utilizado.
El intervalo T6–T7 se mantuvo como comparación descriptiva porque no se pudo verificar un registro prospectivo previo.
No sería metodológicamente correcto reconstruir predicciones después de conocer las respuestas y presentarlas como si hubieran sido formuladas antes.
Este resultado no demuestra que la predicción de visibilidad en IA sea imposible.
Significa que la capacidad predictiva de este método no quedó demostrada en el piloto.
Qué puede aprender una empresa de esta investigación
Aunque no se haya demostrado una ventaja predictiva, el experimento permite extraer recomendaciones prácticas para evaluar la visibilidad en IA.
1. No medir únicamente si una marca aparece
Conviene distinguir reconocimiento, identificación, descripción, recomendación, posición comparativa y citación.
Cada dimensión responde a una pregunta diferente.
2. Formular consultas que representen intenciones distintas
Una pregunta informativa, una pregunta sobre funciones y una pregunta de recomendación no producen necesariamente el mismo tipo de respuesta.
Medir una sola consulta puede ofrecer una imagen incompleta.
3. Comparar los mismos prompts a lo largo del tiempo
Repetir las preguntas con condiciones documentadas ayuda a distinguir entre estados que persisten y cambios observados.
Es importante registrar también las modificaciones de configuración y las incidencias.
4. Revisar las respuestas originales
Una métrica agregada no debería borrar el texto que la originó.
Conservar las respuestas permite revisar ambigüedades, verificar citas y detectar interpretaciones excesivas.
5. No confundir recomendación con verdad objetiva
Que una IA recomiende una plataforma no prueba que sea la mejor del mercado.
Las recomendaciones son resultados observables de una respuesta; su calidad requiere criterios y fuentes independientes.
6. Tratar las citas como evidencia que debe verificarse
La presencia de una referencia no garantiza que respalde exactamente la afirmación.
Es necesario comprobar la fuente, su pertinencia y el contenido que realmente acredita.
7. Exigir pruebas antes de aceptar promesas predictivas
Un sistema que mide la visibilidad actual no es automáticamente un sistema que predice su evolución.
Para validar una predicción es necesario registrarla antes de observar el resultado y compararla con un baseline.
La aportación principal: distinguir lo observado de lo que se afirma
En un ámbito cambiante como la visibilidad en IA, es fácil confundir conceptos próximos.
Una respuesta puede incluir una marca sin recomendarla.
Una recomendación puede aparecer sin que el sistema aporte fuentes suficientes.
Una cita puede estar presente sin respaldar todas las afirmaciones.
Un estado puede mantenerse durante varias semanas sin que exista una regla fiable para predecir cuánto tiempo continuará.
El experimento PCI™-L01 se desarrolló precisamente para estudiar estas diferencias con un procedimiento documentado.
Su aportación no consiste en afirmar que ya conocemos todo el funcionamiento de los sistemas de IA ni en presentar un método predictivo validado.
Consiste en mostrar cómo se pueden formular preguntas controladas, conservar respuestas originales, registrar estados, comparar sistemas y comunicar los resultados sin sobrepasar la evidencia.
También muestra que un resultado negativo tiene valor científico.
En las evaluaciones prospectivas realizadas, PCI™-L01 no superó al baseline de persistencia.
Reconocerlo permite delimitar el alcance del método y evita presentar como demostrada una capacidad que los datos no respaldan.
Conclusión: conocer la representación de una marca exige observar, comparar y verificar
Las cinco preguntas utilizadas en PCI™-L01 permitieron estudiar diferentes aspectos de la representación de Otterly: qué es, a qué categoría pertenece, qué hace, cómo se sitúa frente a otras opciones y si aparece en una recomendación genérica sin ser mencionada previamente.
Las respuestas de ChatGPT, Gemini, Claude y Perplexity ofrecen un conjunto de observaciones directas sobre cómo se representó la plataforma en las condiciones estudiadas entre agosto y octubre de 2026.
El experimento documentó coincidencias en la identificación básica, diferencias en las explicaciones y recomendaciones, incidencias contextuales y cambios entre algunas capturas.
También mostró que la presencia de una marca en una respuesta no debe confundirse con una posición universal de autoridad o liderazgo.
En el ámbito predictivo, la conclusión debe ser igualmente clara: no se ha demostrado que PCI™-L01 permita anticipar la visibilidad futura mejor que una referencia sencilla de persistencia.
Este límite no reduce el valor de la investigación.
Ayuda a establecer una forma responsable de estudiar la visibilidad en IA: observar antes de interpretar, medir antes de comparar, registrar las predicciones antes de conocer los resultados y verificar antes de convertir una respuesta en una afirmación factual.
La inteligencia artificial puede describir, recomendar y citar una marca de maneras diferentes.
Para comprender esas respuestas no basta con preguntar si una empresa aparece.
Es necesario estudiar cómo aparece, en qué contexto, ante qué pregunta, con qué fuentes y con qué estabilidad a lo largo del tiempo.
Ese es el propósito de PCI™-L01 y la principal lección que deja esta investigación.
No se trata de afirmar más sobre la IA, sino de demostrar mejor qué podemos afirmar a partir de sus respuestas.
Manu Duque
AI Visibility Specialist
ai-visibility.es