La inteligencia artificial está transformando la forma en que las personas descubren marcas, comparan productos y reciben recomendaciones.
Que una marca aparezca en una respuesta de IA no demuestra que esté correctamente representada, que la información sea exacta o que esa presencia produzca resultados comerciales.
Esta investigación explora cómo cuatro sistemas de inteligencia artificial ChatGPT, Gemini, Claude y Perplexity, describieron y recomendaron Otterly ante cinco preguntas recurrentes, registradas en ocho momentos de observación entre agosto y octubre de 2026.
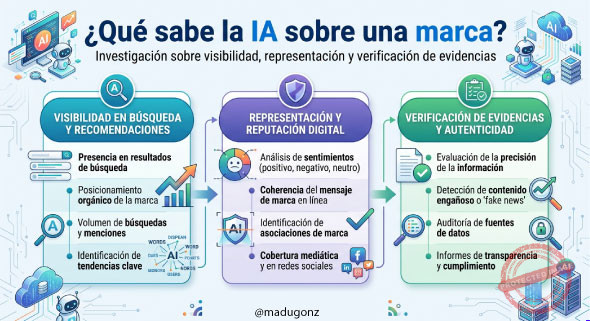
¿Qué sabe la IA sobre una marca? Investigación sobre visibilidad, representación y verificación de evidencias
Autor: Manu Duque
Investigador independiente especializado en AI Visibility Measurement & Predictive AI Visibility Research.
Fecha de actualización: 18 de octubre de 2026
Proyecto: ERIA-00 · Caso de estudio: Otterly · Investigación longitudinal PCI-L01
Resumen
El corpus documental contiene 160 bloques de respuesta.
A partir de ellos se han elaborado instrumentos de auditoría, contraste externo y evaluación semántica.
El proceso también ha permitido detectar errores de extracción, delimitar cuestiones pendientes y diferenciar las afirmaciones de un proveedor de las verificaciones independientes.
El objetivo no es declarar vencedora o perdedora a una herramienta.
Es desarrollar un método para investigar qué dicen los sistemas de IA sobre una entidad, qué puede contrastarse y qué conclusiones todavía no están justificadas.
Conclusión principal: el proyecto dispone de una base documental organizada para estudiar la representación de una marca en respuestas de IA, pero algunas evaluaciones semánticas siguen pendientes y no se ha demostrado de forma concluyente una capacidad predictiva superior a un criterio de persistencia.
Por qué necesitamos investigar la visibilidad en inteligencia artificial
Cuando una persona pregunta a un sistema de IA por una marca, puede recibir una definición, una clasificación, una comparación, una recomendación o una explicación de sus funcionalidades.
Esa respuesta puede influir en cómo entiende la marca y en las opciones que considera.
Pero aparecen varias preguntas que no deberían confundirse:
¿Reconoce correctamente la IA la entidad?
¿Explica con precisión a qué se dedica?
¿Le atribuye características verificables?
¿Distingue sus funcionalidades de las de otras herramientas?
¿Identifica fuentes que respaldan sus afirmaciones?
¿La recomienda y explica por qué?
¿Podemos comprobar lo que dice?
¿Existe evidencia de que esa representación tenga consecuencias comerciales?
La presencia de una marca es solo una parte del fenómeno.
Una mención puede ser correcta, incompleta, ambigua o errónea.
Una recomendación puede resultar razonable sin que exista evidencia suficiente para establecer una superioridad general.
Y una mejora observada en tráfico no demuestra, por sí sola, que una herramienta determinada la haya causado.
Por eso, investigar la visibilidad en IA requiere algo más que contar menciones.
Es necesario analizar el contenido, el contexto, la procedencia de las afirmaciones y los límites de las conclusiones.
La pregunta que orienta este trabajo es:
¿Qué sabe la IA sobre una marca, cómo la representa y qué podemos demostrar de lo que afirma sobre ella?
El caso de estudio: Otterly
Otterly es una herramienta comercial vinculada a la monitorización de la visibilidad de marcas en experiencias de búsqueda con inteligencia artificial.
Se ha elegido como caso de estudio porque permite formular preguntas concretas sobre reconocimiento, clasificación, funcionamiento, cobertura de plataformas, recomendaciones y resultados comerciales.
La investigación no pretende evaluar todas las herramientas de AI Visibility ni representar a todo el mercado.
Estudia una entidad concreta, a partir de un conjunto definido de preguntas y respuestas.
Las conclusiones deben interpretarse dentro de ese alcance.
El propósito tampoco es confirmar por anticipado las afirmaciones del proveedor ni buscar argumentos para refutarlas.
Se trata de formular preguntas verificables y aplicar criterios que permitan distinguir entre información respaldada, información parcial y cuestiones que todavía no pueden resolverse.
Las cinco preguntas que estructuran el experimento
La exploración se organizó en torno a cinco preguntas recurrentes.
P1. ¿Qué es Otterly?
Examina si el sistema identifica la entidad y proporciona una definición comprensible y específica.
P2. ¿A qué categoría pertenece Otterly y qué tipo de solución ofrece?
Permite observar cómo clasifica la IA la herramienta y si distingue entre monitorización, analítica, optimización de contenidos y otras actividades relacionadas.
P3. ¿Qué hace Otterly, cómo funciona y para qué tipo de usuario o empresa puede resultar útil?
Analiza las funcionalidades atribuidas, la explicación del funcionamiento y el tipo de usuario al que se dirige la solución.
P4. Si una empresa busca una solución para mejorar su visibilidad en sistemas de IA, ¿qué opciones debería considerar y qué lugar ocupa Otterly entre ellas?
Examina la recomendación contextual, las alternativas mencionadas y los criterios utilizados para comparar las opciones.
P5. ¿Qué herramientas o plataformas recomendarías para mejorar la visibilidad de una marca en sistemas de inteligencia artificial y por qué?
Amplía el contexto para observar qué soluciones recomienda la IA ante una necesidad general y si explica los motivos de su elección.
Las cinco preguntas forman una secuencia: identificar, clasificar, explicar, comparar y recomendar.
No constituyen una prueba exhaustiva de todas las capacidades de los sistemas estudiados. Son un conjunto de consultas delimitado que permite observar respuestas comparables dentro de este caso.
Cómo se ha realizado la exploración
Se han conservado ocho conjuntos de respuestas, identificados como T0–T7.
En cada ola se utilizaron las cinco preguntas con cuatro sistemas de IA: ChatGPT, Gemini, Claude y Perplexity.
La estructura prevista es de 20 respuestas por ola y el corpus conservado contiene 160 bloques de respuesta.
Hay dos precisiones importantes.
Primera: las respuestas pertenecen a un mismo diseño y las preguntas se repiten. Por tanto, no deben tratarse como 160 experimentos independientes.
Segunda: el archivo T2 presenta una discrepancia entre su nombre, que menciona los días 6–7 de septiembre, y las etiquetas internas, que señalan el 6 de septiembre.
Se mantiene constancia de esta discrepancia en lugar de atribuirle una explicación no verificada.
El proceso ha incluido:
Captura y conservación de las respuestas originales.
Organización del material por ola, plataforma y pregunta.
Auditoría de los bloques RAW.
Contraste de afirmaciones seleccionadas con fuentes externas.
Elaboración de matrices de evaluación.
Revisión de errores de extracción.
Identificación de casos que necesitan una adjudicación semántica completa.
Los documentos RAW se mantienen como material de referencia. Las matrices derivadas facilitan el análisis, pero no sustituyen a las respuestas originales.
Evidencias visibles: qué respondieron realmente los sistemas
Para que el lector pueda examinar ejemplos concretos, se incluyen a continuación tres extractos del material conservado en la evaluación del corpus.
Las citas se reproducen como fragmentos de las respuestas registradas, no como conclusiones verificadas sobre el producto.
Evidencia 1. Definición de la herramienta
Fecha: 23/08/2026 · Ola: T0 · Plataforma: ChatGPT · Pregunta: P1, «¿Qué es Otterly?»
«OtterlyAI es una plataforma de monitorización y optimización de visibilidad en buscadores y sistemas de IA.»
Qué muestra: el sistema sitúa la entidad dentro de la monitorización y optimización de visibilidad en IA.
Qué no demuestra: que todas las funcionalidades atribuidas a la herramienta estén disponibles en cualquier plan, que la solución alcance determinados resultados comerciales o que su eficacia haya sido verificada de manera independiente.
La frase sirve para estudiar la representación de la entidad. Su exactitud y alcance requieren contrastes específicos.
Evidencia 2. Enumeración de plataformas
Fecha: 23/08/2026 · Ola: T0 · Plataforma: Claude · Pregunta: P1, «¿Qué es Otterly?»
«En la práctica, la plataforma permite a marcas y equipos de marketing monitorear cómo aparece su marca en ChatGPT, Perplexity, Google AI Overviews, Gemini, Microsoft Copilot y Google AI Mode, siguiendo menciones de marca, citas de sitios web y posicionamiento frente a la competencia.»
Qué muestra: la respuesta enumera plataformas y describe categorías de información que, según el texto generado, se pueden monitorizar.
Qué debe comprobarse: la enumeración no especifica qué plataformas están incluidas en cada plan, cuáles requieren complementos ni las condiciones comerciales aplicables.
La distinción es esencial: mencionar una plataforma no equivale a afirmar, ni demuestra, que esté incluida en una suscripción concreta.
Evidencia 3. Recomendación en un contexto competitivo
Fecha: 10/10/2026 · Ola: T7 · Plataforma: Perplexity · Pregunta: P4, «Si una empresa busca una solución para mejorar su visibilidad en sistemas de IA, ¿qué opciones debería considerar y qué lugar ocupa Otterly entre ellas?»
«Otterly ocupa una posición muy sólida como opción de entrada y para pymes, agencias o equipos pequeños: es asequible, fácil de operar y cubre los principales…»
Qué muestra: la respuesta formula una recomendación contextual y atribuye a la herramienta cualidades relacionadas con precio, facilidad de uso y cobertura.
Qué no demuestra: que sea objetivamente la mejor opción para todas las pymes o agencias, que sea más asequible que todas las alternativas o que la valoración de facilidad de uso proceda de una comparación independiente.
Este tipo de respuesta resulta especialmente útil para estudiar cómo la IA construye recomendaciones. Pero una recomendación generada no es, por sí misma, una evaluación comparativa validada.
Cómo interpretar estos ejemplos
Los tres fragmentos ilustran tres niveles distintos:
Una definición de entidad.
Una afirmación sobre funcionalidades y cobertura.
Una valoración dentro de un contexto competitivo.
No deben utilizarse como una muestra estadísticamente representativa de las 160 respuestas.
Son ejemplos ilustrativos seleccionados para mostrar por qué la evaluación necesita considerar tanto el texto como la evidencia externa.
Las respuestas originales y los instrumentos de evaluación permiten revisar el contexto de cada caso.
Qué se ha conseguido confirmar hasta ahora
El estado documental permite confirmar varios hitos del proceso.
Corpus organizado. Se han conservado 160 bloques de respuesta distribuidos entre ocho olas de observación.
Preguntas recurrentes. Las cinco preguntas se han utilizado para estructurar comparaciones entre plataformas y momentos.
Instrumentos de evaluación. Se han elaborado documentos de auditoría RAW, contraste externo y evaluación semántica prioritaria.
Errores de extracción detectados. En la revisión se identificaron 65 casos en los que el fragmento extraído correspondía a la pregunta y no a la respuesta del sistema. La versión 0.4 los reclasificó como «No evaluable en esa respuesta».
Casos pendientes identificados. Tras esa corrección permanecen 88 casos de OT-04 y dos de OT-07 que necesitan una revisión semántica completa.
La corrección de esos 65 fragmentos mejora la calidad de la evaluación, pero no significa que las clasificaciones restantes hayan sido validadas de manera definitiva.
Por tanto, el libro de evaluación v0.4 debe tratarse como una versión provisional.
Estado de la investigación
La siguiente tabla separa los hitos documentados, los resultados provisionales y las comprobaciones pendientes.
| Área | Estado a 18/10/2026 | Evidencia o documento |
| Recopilación T0–T7 | Documentada | Ocho archivos RAW originales; 160 bloques |
| Auditoría del corpus | Documentada como instrumento | ERIA-00_RAW_Audit_T0-T7_0.1.xlsx |
| Contraste externo | Instrumento elaborado; conclusiones limitadas a sus fuentes | ERIA-00_Otterly_Corpus_External_Crosscheck_0.1.xlsx |
| Evaluación semántica | Provisional | ERIA-00_Evaluacion_Semantica_Prioritaria_Otterly_0.4.xlsx, versión del 17/10/2026 |
| Corrección de fragmentos | 65 errores de extracción corregidos en v0.4 | Registro de correcciones de la evaluación |
| OT-04: cobertura por plan | Pendiente de revisión completa | 88 casos por cotejar |
| OT-07: impacto comercial y causalidad | Pendiente de revisión completa | 2 casos por cotejar |
| OT-05: método de recogida de datos | Contraste externo preliminar; verificación técnica independiente no resuelta | Documentación del proveedor y matriz de contraste |
| PCI-L01: capacidad predictiva | Sin demostración concluyente de mejora frente al baseline de persistencia | Documentación longitudinal del proyecto |
| ERIA™ como marco | En desarrollo | Criterios e instrumentos de evaluación; validación general pendiente |
Cómo leer la tabla: «Documentada» significa que existe un artefacto o registro identificable del proceso.
No implica que todas las conclusiones derivadas de él estén demostradas. «Provisional» significa que la evaluación todavía puede cambiar tras revisar la evidencia. «Pendiente» indica que no debe presentarse un resultado definitivo.
Fuentes externas: qué respaldan y qué no
El contraste externo debe identificar tanto el contenido de una fuente como su naturaleza.
Una página del proveedor es una fuente válida para saber qué declara la empresa sobre su producto. No es automáticamente una verificación independiente de esa declaración.
Cobertura y condiciones comerciales
La página oficial de precios de Otterly y su artículo de ayuda What are the plans and the pricing of OtterlyAI? describen los motores incluidos en los planes principales y los que se ofrecen como complementos.
En la documentación consultada, los cuatro motores incluidos en los planes principales son:
ChatGPT.
Google AI Overviews.
Perplexity.
Microsoft Copilot.
La misma documentación identifica Claude, Gemini y Google AI Mode como complementos de pago.
Tipo de evidencia: documentación comercial del proveedor.
Qué permite afirmar: que la oferta publicada por Otterly distingue entre esos cuatro motores principales y los complementos identificados en la documentación consultada.
Qué no permite afirmar: que las condiciones sean inmutables, que se apliquen a cualquier contrato especial o que la página actual refleje necesariamente las condiciones de todas las fechas anteriores del experimento.
Los precios, planes y funcionalidades deben comprobarse en la fuente vigente en el momento de una decisión comercial.
Método de recogida de datos
En su artículo How OtterlyAI collects data?, publicado el 17 de julio de 2026 según la página consultada, Otterly afirma que interactúa programáticamente con las interfaces web públicas de las plataformas y que utiliza una API para Claude.
La documentación también describe una monitorización diaria y advierte que las respuestas pueden variar según la ubicación, la sesión y la configuración de la cuenta.
Tipo de evidencia: declaración metodológica del proveedor.
Qué permite afirmar: que Otterly publica esa descripción de su método.
Qué no permite afirmar: que una auditoría técnica independiente haya confirmado la implementación real de cada paso, la equivalencia de todas las respuestas capturadas con las que reciben los usuarios o la ausencia de variaciones adicionales.
Para una verificación técnica independiente harían falta pruebas diseñadas para esa finalidad, como observaciones replicables, registros técnicos adecuados o una auditoría independiente con metodología explícita.
No haber localizado esa verificación durante esta revisión no demuestra que el método sea falso. Significa que la cuestión no está resuelta de forma independiente con la evidencia examinada.
Resultados comerciales y casos de éxito
La página oficial de casos de éxito de Otterly reúne ejemplos de clientes y resultados que el proveedor asocia al uso de la herramienta.
Un caso concreto es Instant Commerce Doubles AI Search Traffic with OtterlyAI, que presenta afirmaciones sobre el crecimiento de visibilidad y tráfico procedente de buscadores con IA.
Tipo de evidencia: caso de éxito publicado por el proveedor y declaraciones atribuidas a un cliente.
Qué permite afirmar: que el proveedor publica ese caso y presenta esos resultados como parte de su experiencia comercial.
Qué no permite afirmar por sí solo: que Otterly sea la causa única de los resultados, que el mismo efecto se produzca en otros clientes o que exista una relación causal general entre utilizar la herramienta y aumentar el tráfico o las ventas.
Para sostener una conclusión causal más amplia sería necesario examinar datos, atribución, periodos de comparación, cambios concurrentes y un diseño capaz de evaluar explicaciones alternativas.
Qué significa contrastar una fuente
Una fuente externa no convierte automáticamente una afirmación en un hecho demostrado.
Es necesario valorar qué está en condiciones de acreditar.
La documentación de precios puede acreditar las condiciones que el proveedor publica.
Una respuesta de IA puede acreditar lo que ese sistema dijo en una consulta concreta.
Un caso de éxito puede acreditar que el proveedor comunica un resultado atribuido a un cliente.
Ninguno de esos materiales, por separado, responde necesariamente a todas las preguntas sobre funcionamiento técnico, eficacia o causalidad.
La calidad del análisis depende de que la conclusión no exceda lo que la fuente puede respaldar.
De la respuesta a la evaluación: el método de trabajo
El proyecto ERIA-00 busca convertir afirmaciones relevantes en unidades que puedan revisarse y justificarse.
Para cada caso de evaluación, el objetivo es registrar:
La afirmación sometida a examen.
La plataforma, la pregunta y la fecha.
La respuesta original completa.
Una cita literal con contexto suficiente.
La fuente externa utilizada, cuando corresponda.
La decisión de evaluación.
La justificación.
El nivel de confianza.
Las limitaciones que impiden cerrar la cuestión.
Este diseño permite distinguir varias situaciones.
Correcta y respaldada: la afirmación está suficientemente respaldada por la evidencia disponible para el alcance evaluado.
Parcial o incompleta: la respuesta contiene información relevante, pero omite una distinción necesaria, presenta una generalización o no especifica una condición importante.
No evaluable en esa respuesta: el texto no contiene información suficiente para evaluar la afirmación en cuestión.
No resoluble: la evidencia disponible no permite llegar a una conclusión suficientemente fundamentada.
La clasificación «Incorrecta o contradicha» requiere evidencia que contradiga la afirmación evaluada.
No debe utilizarse simplemente porque no se haya encontrado respaldo.
Estas categorías son instrumentos de trabajo, no una garantía de objetividad automática.
Las reglas deben aplicarse de forma consistente y los casos relevantes requieren revisión semántica, contexto y justificación.
ERIA™: investigar cómo se representan las entidades
ERIA™ Entity Representation in AI es el marco que se está desarrollando para estudiar cómo los sistemas de IA reconocen, representan, atribuyen y recomiendan entidades.
Su propósito es separar dimensiones que a menudo aparecen mezcladas:
Reconocimiento e identificación.
Categoría y función.
Atributos y diferenciación.
Atribución de fuentes.
Recomendación y justificación.
Evolución de la representación a lo largo del tiempo.
El caso de Otterly permite probar cómo funcionan estos criterios ante respuestas reales, pero no constituye por sí mismo una validación general de ERIA™.
Para considerar el marco validado en un sentido más amplio harían falta criterios operativos suficientemente definidos, pruebas de consistencia entre evaluadores, procedimientos reproducibles y aplicaciones a otros casos.
Por ahora, la aportación debe entenderse como el desarrollo documentado de un método de evaluación y la identificación de problemas que conviene resolver antes de ampliar sus conclusiones.
La investigación longitudinal y los límites de la predicción
El proyecto también se relaciona con PCI-L01, una exploración sobre visibilidad predictiva.
La pregunta de investigación es si determinadas señales observables de visibilidad contienen información sobre el estado futuro de esa visibilidad, cuánto tiempo antes lo hacen y si aportan más información que un criterio sencillo de persistencia.
La secuencia conceptual es:
Observación → medición → evolución → predicción.
Las ocho olas permiten estudiar cambios entre momentos de observación. Sin embargo, describir una evolución no equivale a predecirla.
Una prueba predictiva requiere definir qué se quiere anticipar, separar adecuadamente los datos utilizados para formular la predicción de los utilizados para evaluarla y establecer un criterio de comparación.
En PCI-L01 no se ha obtenido una demostración concluyente de mejora frente a un baseline de persistencia.
Por tanto, no corresponde afirmar que el proyecto haya validado un modelo predictivo de AI Visibility.
Sí ha permitido documentar el proceso, conservar observaciones y reconocer qué condiciones son necesarias para una evaluación predictiva más rigurosa.
Un resultado que no confirma una hipótesis también es informativo si delimita con claridad qué se ha probado y qué no.
Qué hemos demostrado, qué sabemos y qué permanece abierto
Es útil distinguir tres niveles.
Lo que está documentado
La existencia de ocho conjuntos de respuestas conservados.
La estructura de cinco preguntas y cuatro plataformas.
La existencia de instrumentos de auditoría, contraste externo y evaluación semántica.
La detección y corrección de 65 errores de extracción.
La identificación de casos que requieren revisión semántica adicional.
La existencia de documentación comercial del proveedor sobre cobertura por plan, método de recogida y casos de éxito.
Lo que podemos estudiar a partir del corpus
Cómo describen estas cuatro plataformas a Otterly ante las preguntas utilizadas.
Qué diferencias aparecen entre respuestas y momentos de observación.
Qué afirmaciones requieren contraste externo.
Qué partes de una recomendación son descriptivas y cuáles incorporan valoraciones.
Qué cambios observados pueden formularse como hipótesis para una investigación posterior.
Cada conclusión concreta debe apoyarse en la respuesta original y en una evaluación adecuada.
La existencia del corpus no valida automáticamente todas las interpretaciones posibles.
Lo que no podemos presentar todavía como demostrado
Que las respuestas representen el comportamiento de todos los usuarios o consultas.
Que la representación observada sea permanente o universal.
Que una recomendación generada demuestre superioridad comercial.
Que la utilización de una herramienta cause necesariamente un incremento de tráfico, ventas o ingresos.
Que el método de recogida declarado por el proveedor haya sido verificado técnicamente de forma independiente.
Que PCI-L01 haya demostrado una capacidad predictiva superior a la persistencia.
Que las evaluaciones semánticas pendientes estén cerradas.
Esta distinción no implica que las afirmaciones pendientes sean falsas.
Indica que todavía no existe evidencia suficiente, dentro del alcance de esta revisión, para presentarlas como conclusiones definitivas.
Qué utilidad tiene para empresas, profesionales y usuarios
Para una empresa que busca una herramienta, este enfoque ayuda a formular preguntas más concretas:
¿Qué plataformas se monitorizan y cuáles están incluidas en el plan?
¿Qué información entrega la herramienta?
¿Cómo describe el proveedor el método de recogida?
¿Qué afirmaciones cuentan con fuentes independientes?
¿Qué resultados son observaciones y cuáles son inferencias?
¿Qué evidencia respalda las afirmaciones sobre impacto comercial?
Para profesionales de SEO, marketing y comunicación, permite distinguir entre aparecer en una respuesta, ser descrito correctamente, ser recomendado y estar respaldado por fuentes.
Para investigadores, ofrece un ejemplo de conservación de respuestas, análisis longitudinal y registro de decisiones de evaluación.
Para los usuarios, promueve una práctica sencilla: pedir que las afirmaciones relevantes sean específicas, verificables y proporcionales a la evidencia disponible.
El objetivo no es desacreditar herramientas ni promover una solución concreta. Es mejorar la calidad de las preguntas y de los criterios con los que se evalúa la visibilidad en IA.
Conclusión: no basta con aparecer, también importa qué podemos demostrar
La pregunta «¿qué sabe la IA sobre una marca?» no tiene una única respuesta.
Depende del sistema consultado, la pregunta formulada, el momento de observación, las fuentes disponibles y los criterios de evaluación.
Por eso, estudiar la visibilidad en IA exige distinguir reconocimiento, representación, atribución, recomendación, evolución e impacto.
El caso de Otterly ha permitido organizar una exploración longitudinal, conservar respuestas originales, detectar errores de extracción y establecer instrumentos de contraste.
También ha permitido identificar comprobaciones pendientes y reconocer que la investigación predictiva no ha demostrado de forma concluyente una mejora frente a un baseline de persistencia.
No es una validación universal de ERIA™, una auditoría técnica completa de Otterly ni una prueba causal de los efectos comerciales de la visibilidad en IA.
Es una base documental desde la que seguir investigando.
Mi objetivo como investigador independiente es contribuir a que la visibilidad en inteligencia artificial se estudie con menos ambigüedad y más evidencia: comprender cómo se reconocen y representan las entidades, definir qué puede medirse, contrastar las afirmaciones y reconocer lo que permanece sin resolver.
Porque en la visibilidad en IA no basta con aparecer. También importa qué se dice, por qué se dice y qué podemos demostrar sobre ello.
Fuentes y documentos de referencia
Fuentes externas
OtterlyAI – página oficial de precios. Fuente comercial del proveedor sobre planes, motores incluidos y complementos.
OtterlyAI Help Center – planes y precios. Documentación del proveedor sobre cobertura y condiciones comerciales.
OtterlyAI Help Center – cómo recoge los datos. Descripción del método según el proveedor; no equivale a una auditoría técnica independiente.
OtterlyAI – casos de éxito. Casos publicados por el proveedor.
Instant Commerce – caso de éxito publicado por OtterlyAI. Fuente comercial con afirmaciones sobre resultados de cliente; no demuestra por sí sola causalidad general.
Nota de alcance
La investigación se basa en un corpus específico de respuestas recogidas entre agosto y octubre de 2026.
Los resultados no deben generalizarse automáticamente a otras marcas, plataformas, preguntas o usuarios.
La revisión semántica de OT-04 y OT-07 continúa pendiente, y OT-05 requiere distinguir la documentación del proveedor de la verificación técnica independiente. Las condiciones comerciales pueden cambiar; los enlaces anteriores deben consultarse de nuevo antes de tomar decisiones de compra.
Este artículo tiene una finalidad informativa y metodológica.
Su propósito es documentar lo observado, delimitar lo verificable y ayudar a evaluar de forma crítica las afirmaciones sobre visibilidad en inteligencia artificial.
Manu Duque
AI Visibility Specialist
ai-visibility.es