Cómo un estándar de 1988 predijo el problema de la visibilidad en motores generativos
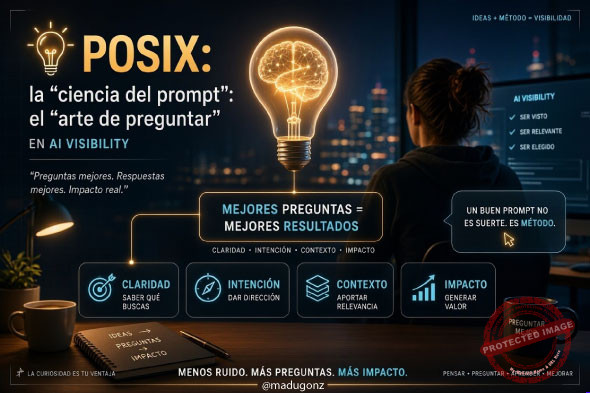
POSIX es el término técnico que significa «Índice de Sensibilidad al Prompt» y que toma su nombre del veterano estándar informático «Portable Operating System Interface» por la analogía de medir la estabilidad y portabilidad de un sistema, en este caso, de la IA.
I. Los señores de la guerra de Unix (1988)
A finales de los años ochenta, el mundo de la informática vivía una guerra que hoy casi nadie recuerda.
No era una guerra de ejércitos, sino de variantes.
Unix se había multiplicado como un organismo primitivo: AT&T tenía la suya, Berkeley distribuía la suya, Sun, HP, IBM y DEC defendían cada una la propia.
Eran primos que se reconocían en la mesa de Navidad pero no podían intercambiarse los regalos.
Un programa escrito para una variante no compilaba en otra.
Las llamadas al sistema esas instrucciones mínimas que un programa le hace al sistema operativo para leer un archivo, reservar memoria, abrir una conexión, tenían nombres distintos, semánticas ligeramente distintas, comportamientos en los bordes que nadie documentaba igual.
Para un desarrollador, aquello era una condena.
Escribías el mismo programa tres veces, cuatro veces, cinco, una por plataforma.
El coste de la portabilidad era el coste de la duplicación. Y cada duplicación introducía su propio error.
En 1988, el IEEE publicó el estándar 1003.1
Allí se definía, por primera vez de forma formal, un conjunto mínimo de interfaces que cualquier sistema tipo Unix debía ofrecer para que un programa pudiera migrar entre ellos sin reescribirse.
El nombre que se adoptó fue POSIX.
La historia del acrónimo tiene su gracia: Richard Stallman había propuesto el término, y alguien la memoria colectiva no se pone de acuerdo sobre quién añadió la X final para marcar la herencia de Unix.
POSIX: Portable Operating System Interface.
La X no significaba nada en particular, y por eso significaba todo: era la firma de una familia.
Lo importante no es el nombre. Lo importante es lo que el estándar prometía. POSIX no prometía que todos los sistemas fueran iguales.
Prometía algo más humilde y más útil: que un programa escrito contra esa interfaz sobreviviría al cambio de plataforma.
Que lo que funcionaba en un sistema funcionaría en otro, no porque los sistemas se hubieran vuelto idénticos, sino porque existía un contrato sobre qué partes eran invariantes.
Esa fue la lección. La fragmentación no se resuelve unificando el mundo.
Se resuelve definiendo qué es lo que no debe cambiar cuando todo lo demás cambia.
II. El giro (2024)
Treinta y seis años después, en un laboratorio de procesamiento de lenguaje natural, un investigador se enfrenta a un problema que reconoce inmediatamente, aunque no lo haya vivido.
Está evaluando modelos de lenguaje. Ha construido un banco de pruebas con preguntas cuidadosamente redactadas.
Ejecuta el modelo, anota las respuestas.
Y luego, por rutina, por escepticismo, por esa manía de los buenos metodólogos de desconfiar de su propio instrumento, reescribe una de las preguntas. Cambia «mejores» por «principales».
No cambia el sentido. No cambia la intención. Cambia tres letras y una sílaba.
El modelo devuelve una respuesta distinta.
No una respuesta ligeramente distinta: una respuesta que recomienda marcas diferentes.
El investigador prueba con otra variante. Otra respuesta.
Prueba a ejecutar el mismo prompt cinco veces seguidas para descartar la aleatoriedad del muestreo.
Ahí la respuesta sí se mantiene razonablemente estable.
La conclusión se le impone: el ruido no viene del modelo, viene de la pregunta.
Necesita un nombre para lo que acaba de medir.
No mide exactitud no hay una respuesta correcta en «¿cuál es el mejor CRM?».
No mide coherencia el modelo es coherente consigo mismo.
Mide algo más específico: la sensibilidad de la respuesta a variaciones del prompt que preservan la intención.
Un índice de esa sensibilidad.
Y elige, medio en broma, medio en homenaje, el nombre que la informática ya había gastado: POSIX. Prompt Sensitivity Index.
La X, de nuevo, como firma de familia.
Los dos POSIX no son hermanos. No son el mismo estándar en dos capas de abstracción.
Uno es una norma formal del IEEE; el otro es una métrica de investigación.
Pero comparten un problema, y ese problema es el que este ensayo quiere poner sobre la mesa: en ambos casos, alguien descubre que su medición no sobrevive al cambio de entorno, y responde inventando un estándar de invariancia.
La informática aprendió esa lección en 1988.
La visibilidad en motores generativos está aprendiéndola ahora, y aún no ha firmado su tratado.
III. La traducción técnica: qué mide el nuevo POSIX
Conviene bajar a los números, porque la metáfora sola no sostiene un argumento.
La evidencia disponible sobre sensibilidad al prompt es sorprendentemente consistente entre estudios, y sus magnitudes son las que hacen que el problema sea serio.
La comparación más limpia es esta: ¿cuánto se parecen las recomendaciones de dos formas distintas de hacer la misma pregunta, frente a las recomendaciones de la misma pregunta repetida varias veces?
Un estudio a gran escala, con alrededor de seis mil ejecuciones de paráfrasis y otras tantas reejecuciones de control, midió esa similitud con el índice de Jaccard una forma de cuantificar el solapamiento entre dos conjuntos, donde 1 significa «idénticos» y 0 «sin nada en común».
Los resultados:
Dos paráfrasis cosméticas cambiar «mejores» por «principales», reordenar la frase comparten, de media, un 0,288 de sus recomendaciones.
Dos paráfrasis con restricción añadida «mejores CRM» frente a «mejores CRM para una startup SaaS» comparten un 0,135.
Dos ejecuciones del mismo prompt exacto comparten entre 0,50 y 0,61.
Léase despacio. La variación que introduce reformular la pregunta es entre dos y cuatro veces mayor que la variación que introduce la aleatoriedad del propio modelo.
El instrumento pesa más que el objeto medido.
Hay más. Existe un umbral de similitud semántica medida con embeddings, esos vectores que capturan el significado por debajo del cual la probabilidad de que una marca sea mencionada se desploma.
El umbral se sitúa en torno a 0,50–0,60 de similitud coseno, y varía según el motor.
Por encima de ese umbral, la visibilidad se mantiene estable.
Por debajo, en la franja de 0,35–0,39, la tasa de mención cae alrededor de un 50% relativo respecto a la línea base.
No es una pendiente suave: es un acantilado.
Y hay un tercer efecto, el más incómodo para quien confía en la neutralidad del instrumento.
El encuadre de la pregunta comparativo, exploratorio, de recomendación directa activa marcos de respuesta que persisten.
Un marco elegido puede mantener una ventaja mediana de hasta 12,43 puntos de tasa de mención frente a la deriva natural de 0,83–1,36 puntos.
Traducido: si eliges el encuadre, eliges en parte el ganador.
El POSIX de la IA, en su formulación técnica, intenta capturar esto de forma continua.
En lugar de un indicador binario «la marca aparece o no aparece», mide la confianza interna del modelo en su propia respuesta, y observa cuánto se sacude esa confianza al perturbar el prompt.
Un POSIX bajo indica un instrumento estable. Un POSIX alto indica que pequeñas variaciones de redacción están moviendo los resultados de forma artificial, y que cualquier conclusión sobre visibilidad construida sobre ese instrumento está contaminada.
Para quien no tenga formación técnica, la analogía útil es la del termómetro.
Un termómetro fiable da 37,2 hoy y 37,2 mañana si la fiebre no ha cambiado.
Si lo agitas un poco y marca 36,5, y lo agitas otra vez y marca 38,1, el problema no es el paciente: es el instrumento.
POSIX es la prueba de agitación del termómetro.
IV. La lección de portabilidad
Aquí está el corazón del argumento, y conviene enunciarlo con precisión porque es fácil de malinterpretar.
El POSIX original no medía programas.
Medía si un programa sobrevivía al cambio de sistema.
Su objeto no era el software, sino la relación entre el software y su entorno.
Un programa era «POSIX-compliant» no si era bueno, sino si seguía funcionando cuando lo movías de sitio.
El nuevo POSIX no mide marcas.
Mide si una conclusión de visibilidad sobrevive al cambio de formulación.
Su objeto no es la marca, sino la relación entre la marca y la pregunta que la invoca.
Un panel de prompts es «robusto» no si produce números bonitos, sino si esos números siguen siendo los mismos cuando cambias la redacción sin cambiar la intención.
La simetría es exacta, y su consecuencia práctica también.
Durante décadas, la industria del software aceptó que la portabilidad era un requisito de ingeniería, no un lujo.
Un programa que solo funcionaba en una plataforma era un programa a medio hacer.
Nadie habría aceptado, en 1995, un sistema que se rompiera al cambiar de compilador. Se habría considerado negligencia.
La visibilidad en motores generativos, en cambio, acepta hoy como normal algo que la ingeniería del software consideraría inaceptable: que el resultado de la medición dependa de la redacción exacta de la pregunta, y que nadie lo reporte.
Un panel de prompts que produce un «47,3% de visibilidad» sin declarar su varianza entre variantes es el equivalente a un programa que funciona en tu máquina y falla en la del cliente.
La diferencia es que el fallo del programa se nota.
El fallo del panel se convierte en una decisión estratégica mal informada.
La lección de portabilidad, entonces, no es una metáfora decorativa.
Es una transferencia de criterio: lo que la informática aprendió a exigir de sus instrumentos, la medición de visibilidad debe aprender a exigirlo de los suyos.
V. La competencia desleal (y por qué el ensayo gana al admitirla)
Sería fácil terminar aquí, con la conclusión reconfortante de que el prompt lo explica todo y que basta con calibrar paneles para resolver el problema.
Sería también deshonesto. La evidencia reciente impone una cautela simétrica, y este ensayo sería peor sin ella.
Un modelo por etapas construido sobre casi treinta y cinco mil observaciones de pares prompt-motor sin marca previa, para evitar sesgos de selección encontró que cuando ni la marca objetivo ni su dominio propio aparecen en la ruta de recuperación observable, las tasas de mención en GPT y Gemini son del 2,8% y 3,8% respectivamente.
Cuando coinciden la citación del dominio propio y el fan-out de marca la dispersión de consultas derivadas que el motor genera alrededor del nombre, esas tasas suben al 91,4% y al 100%.
Compárense las magnitudes.
La sensibilidad al prompt mueve la aguja en el orden de decenas de puntos porcentuales de dispersión.
La exposición de recuperación mueve la aguja en el orden de decenas de puntos porcentuales de nivel. No compiten en el mismo eje.
Esto tiene una consecuencia importante para el argumento de este ensayo, y conviene formularla sin ambigüedad: la ciencia del prompt es una teoría del error de medición, no una teoría causal de la visibilidad.
Nos dice en qué medida una cifra es fiable. No nos dice cómo subir esa cifra.
Para lo segundo hacen falta la exposición de dominio, el fan-out de marca y la estrategia de contenido, que son problemas distintos y se resuelven con instrumentos distintos.
Quien confunda ambas cosas acabará optimizando formulaciones de preguntas en lugar de corregir deficiencias de recuperación.
Sería como el programador de 1990 que, en lugar de adoptar POSIX, se dedicara a reescribir su programa para cada plataforma y llamara a eso «estrategia multiplataforma».
Funciona, hasta que deja de funcionar.
VI. El tratado pendiente
Si la analogía tiene algún valor práctico, debería traducirse en un programa.
No en una métrica más, sino en un estándar de portabilidad del instrumento el equivalente, para la visibilidad, de lo que el IEEE 1003.1 fue para Unix.
¿Qué contendría ese tratado? Cuatro cláusulas, todas ellas ya presentes en la literatura, ninguna de ellas exigida hoy por la práctica estándar.
Primera: procedencia documentada.
Todo panel de prompts debe declarar de dónde salen sus preguntas.
La evidencia muestra que la procedencia redactado nativamente, generado por máquina, observado en consultas reales produce resultados sistemáticamente distintos, con brechas de hasta 24 puntos porcentuales en tasas de citación según el idioma.
Un panel sin procedencia declarada es un panel sin trazabilidad.
Segunda: distribución semántica.
Todo panel debe reportar la similitud semántica media entre sus prompts y los del clúster de intención que dice representar.
Si el panel se concentra en una zona estrecha del espacio semántico, su cobertura es ficticia.
Si se dispersa por debajo del umbral de 0,50–0,60, está midiendo intenciones distintas y llamándolas la misma.
Tercera: cobertura de marcos.
Todo panel debe declarar qué encuadres activa comparativo, exploratorio, de recomendación, transaccional y en qué proporción.
Dado que el encuadre puede mantener ventajas de hasta 12,43 puntos, un panel que sobrerrepresenta un marco está favoreciendo sistemáticamente a las marcas que ese marco invoca.
Cuarta: varianza reportada junto al promedio.
Esta es la cláusula que más resistencia encontraría y la más importante.
Todo informe de visibilidad debería incluir la desviación estándar del panel entre variantes, no solo la media. Un «47,3% ± 18,2 puntos» cuenta una historia distinta de un «47,3% ± 3,1 puntos».
La primera dice: no compares marcas con estos datos. La segunda dice: puedes hacerlo con cautela.
La gobernanza del instrumento vivo no es un lujo metodológico.
Es la condición para que las decisiones estratégicas basadas en visibilidad IA dejen de ser apuestas y empiecen a ser inferencias.
VII. Cierre
Un estándar es una promesa de que lo que mediste ayer significa lo mismo hoy.
Esa promesa es la que hace posible la ingeniería.
Sin ella, cada programa sería una isla, cada medición un idioma privado, cada conclusión un acto de fe.
El POSIX de 1988 no fue un triunfo técnico: fue un acto de humildad colectiva.
Los señores de la guerra de Unix admitieron que la fragmentación era el problema, y aceptaron un contrato que limitaba su libertad a cambio de que sus programas sobrevivieran en el mundo de los demás.
La visibilidad en motores generativos aún no ha hecho esa promesa.
Reporta porcentajes precisos sobre instrumentos cuya varianza no declara, compara marcas sobre paneles cuya distribución semántica desconoce, y atribuye a la estrategia de marca lo que en parte es la redacción de la pregunta.
POSIX las dos veces es el recordatorio de lo que cuesta no hacer la promesa.
La primera vez costó una década de programas reescritos.
La segunda está costando decisiones estratégicas tomadas sobre números que no sobreviven al cambio de una coma.
La pregunta no es si la visibilidad IA necesita su POSIX. La pregunta es cuánto tardará en admitir que lo necesita.
Nota sobre el método: las escenas de 1988 y de 2024 son reconstrucciones narrativas de procesos documentados la adopción del estándar IEEE 1003.1 y el desarrollo de métricas de sensibilidad al prompt, respectivamente, no transcripciones literales.
Los datos empíricos citados Jaccard 0,288 / 0,135 / 0,50–0,61; umbral 0,50–0,60; caída relativa del 50%; ventaja de encuadre de 12,43 puntos; brechas de procedencia de hasta 24 puntos; tasas de mención de 2,8% / 3,8% / 91,4% / 100% provienen de la literatura reciente sobre sensibilidad al prompt y recuperación en motores generativos, y se han mantenido con su magnitud original para permitir su verificación.