Protocolo de Investigación — Operación NEXARA
Versión: 0.1 (borrador)
Fecha: 14 de noviembre de 2026
Autor: Manu Duque
Estado: Borrador para revisión metodológica
Glosario canónico: https://www.manuduque.com/glosario-canonico-avm/
Aviso de prioridad interpretativa. Las definiciones vigentes del glosario canónico prevalecen sobre cualquier formulación contenida en este documento. Cuando exista discrepancia entre una formulación operativa aquí presentada y una definición canónica, prevalecerá la definición canónica. Los términos nuevos introducidos en este protocolo se marcan explícitamente como “pendiente de incorporación al glosario”.
1. Resumen ejecutivo
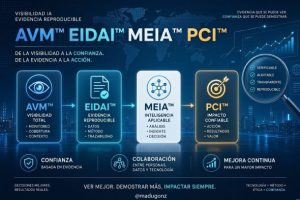
Este protocolo especifica el diseño de la Operación NEXARA, una aplicación experimental de los marcos AVM™, EIDAI™, ERIA™ y PCI™, documentada conforme a MEIA™. NEXARA investiga si es posible observar y comparar la visibilidad de una entidad en cuatro sistemas de IA generativa (ChatGPT, Gemini, Claude y Perplexity) mediante un corpus controlado de prompts, con reglas de codificación explícitas y trazabilidad completa. El diseño prevé 25 prompts (20 experimentales en cuatro categorías, 5 de control neutro), cinco ejecuciones por prompt y modelo, y un total previsto de 500 observaciones. La Fase 0 establece una base observacional; las fases de ampliación se activan solo si se cumplen criterios preregistrados. No se presentan resultados obtenidos: todas las cifras son tamaño previsto del diseño. PCI™ no se valida en Fase 0; solo se preregistra su lógica de comparación frente a un baseline de persistencia. El objetivo es que un tercero independiente pueda replicar el procedimiento y auditar cada decisión.
2. Pregunta de investigación e hipótesis
2.1 Pregunta principal
¿En qué medida una entidad definida es reconocida, identificada, descrita y recomendada por cuatro sistemas de IA generativa, bajo condiciones de consulta controladas, y qué grado de consistencia presenta esa observación entre ejecuciones repetidas del mismo prompt?
2.2 Subpreguntas
SP1. ¿La entidad aparece en las respuestas a prompts de descubrimiento espontáneo, comparación directa, resolución de problemas y validación de marca, y con qué frecuencia relativa por categoría?
SP2. Cuando la entidad aparece, ¿es identificada correctamente conforme a los criterios de EIDAI™, o se producen confusiones por homonimia, atribución incorrecta o contaminación contextual?
SP3. ¿Qué calidad de recomendación presenta la entidad en la escala ordinal 0–3, y difiere esa calidad entre categorías de prompt?
SP4. ¿Existe consistencia entre las cinco ejecuciones del mismo prompt en el mismo modelo, o la variabilidad intra-prompt es sustancial?
SP5. ¿El estado observado en Fase 0 es compatible con una hipótesis de persistencia a corto plazo, según la lógica preregistrada de PCI™?
2.3 Hipótesis H1 y criterio de falsación
H1 (hipótesis de observabilidad consistente): Para al menos una categoría de prompt y al menos un modelo, la tasa de aparición limpia de la entidad (codificación binaria primaria, excluyendo apariciones contaminadas según EIDAI™) será estable en al menos 4 de 5 ejecuciones del mismo prompt.
Criterio de falsación explícito: H1 se considerará no apoyada si, para todas las combinaciones de categoría × modelo, la aparición limpia ocurre en 3 o menos de 5 ejecuciones en más del 50% de los prompts de esa categoría. La falsación no invalida el estudio: documenta que la visibilidad observada es inestable bajo las condiciones del diseño.
Nota metodológica. H1 no afirma que la entidad “sea visible” en términos generales. Afirma una propiedad acotada: consistencia intra-prompt bajo condiciones registradas. La generalización más allá de esta ventana y este corpus no está cubierta por H1.
2.4 Análisis de potencia previsto
No se realiza análisis de potencia formal en la versión 0.1, porque no existe una estimación previa de la varianza intra-prompt para esta entidad y este corpus. El diseño de 5 ejecuciones por prompt es una decisión de factibilidad operativa, no un cálculo de potencia. Antes de la ejecución, el investigador registrará una declaración de que el tamaño muestral permite describir consistencia intra-prompt (5 ejecuciones) pero no estimar proporciones poblacionales con precisión estrecha. Cualquier inferencia sobre diferencias entre modelos o categorías se tratará como exploratoria y se reportará con intervalos agrupados por prompt, no sobre el total de 500 registros.
3. Marco metodológico
3.1 Aplicación de los marcos en este protocolo
Marco
Función en NEXARA
Lo que no hace en este protocolo
AVM™
Define las dimensiones de observación: frecuencia de aparición, cobertura entre modelos, consistencia intra-prompt, contexto de aparición, calidad de recomendación
No produce una puntuación única de visibilidad
EIDAI™
Establece las reglas de reconocimiento, identificación, desambiguación y exclusión de apariciones contaminadas
No evalúa la representación completa de la entidad
ERIA™
Proporciona el marco conceptual para distinguir representación expresada (descripción, categoría, atributos) de comportamiento relacionado (recomendación)
No se operacionaliza como dimensión independiente en Fase 0; se usa como guía de distinción
PCI™
Se preregistra la lógica de comparación frente a un baseline de persistencia, pero no se ejecuta validación predictiva en Fase 0
No se afirma capacidad predictiva
MEIA™
Documenta trazabilidad: registro de decisiones, conservación de respuestas RAW, separación entre observación e interpretación, versionado
No produce métricas; no es un operacionalizador
3.2 Aclaración sobre MEIA™
MEIA™ es transversal. No define las escalas ni las métricas de NEXARA. Su función es establecer las condiciones para que la operacionalización sea verificable: que cada decisión tenga una regla explícita, que las respuestas originales se conserven sin modificación, que las anomalías se registren y no se eliminen, y que la distinción entre diseño y resultado sea visible en todo el documento .
4. Diseño del estudio
4.1 Fases
Fase
Contenido
Condición de activación
Fase 0
Captura base: 25 prompts × 4 modelos × 5 ejecuciones (500 observaciones previstas). Ventana de 14 días.
Ninguna. Es la fase inicial.
Fase 1 (prevista)
Repetición de la captura en una segunda ventana temporal, con los mismos prompts y modelos, para comparación descriptiva de persistencia.
Se activa solo si Fase 0 se cierra con ≥90% de observaciones válidas registradas y sin anomalías mayores no documentadas.
Fase 2 (prevista)
Ampliación a una segunda entidad del mismo sector.
Se activa solo si Fase 1 se completa y el investigador publica una adenda de protocolo con los criterios de comparación entre entidades.
Nota metodológica. Las fases de ampliación no forman parte del diseño ejecutado en la versión 0.1. Su inclusión aquí es preregistral: documenta que el estudio no pretende generalizar desde un solo caso y que cualquier ampliación futura tendrá sus propias reglas públicas.
4.2 Ventana temporal y oleadas
La Fase 0 se ejecuta en una ventana de 14 días naturales. Dentro de esa ventana, cada prompt se ejecuta en 5 ocasiones separadas, distribuidas en al menos 3 días distintos y en 2 franjas horarias distintas (mañana/tarde, según hora local del investigador). La distribución exacta de fechas y horas se registra en la plantilla de ejecución (Anexo A) antes de iniciar la captura.
4.3 Unidad de análisis
La unidad de análisis es el prompt, no la ejecución individual. Cada prompt genera un conjunto de 5 ejecuciones por modelo. Las métricas de consistencia se calculan dentro de ese conjunto. Las ejecuciones individuales son observaciones anidadas dentro del prompt; no se tratan como unidades independientes para inferencia entre prompts.
5. Corpus de prompts
5.1 Prompts experimentales (20)
Los prompts se formulan en español neutro, sin mencionar la entidad objetivo en los prompts de descubrimiento espontáneo y resolución de problemas. La entidad objetivo se define en la ficha de identidad (Anexo B) antes de la captura.
Categoría
N
Propósito
Regla de reporte
Descubrimiento espontáneo
5
Solicitar recomendaciones o listados sin mencionar la entidad. Ejemplo: “¿Qué herramientas existen para monitorizar la visibilidad de marcas en asistentes de IA?”
Reporte separado. La aparición aquí es la señal más próxima a “descubrimiento no provocado”.
Comparación directa
5
Solicitar comparación entre la entidad y alternativas, o entre categorías que incluyen la entidad.
Reporte separado. La aparición es esperada por el diseño del prompt; mide calidad comparativa, no descubrimiento.
Resolución de problemas
5
Plantear una necesidad o problema que la entidad podría resolver, sin nombrarla.
Reporte separado. La aparición indica relevancia percibida para una necesidad declarada.
Validación de marca
5
Mencionar explícitamente la entidad y solicitar información, validación o recomendación sobre ella.
Reporte separado y etiquetado como reconocimiento provocado. No se agrega con las categorías anteriores en ningún indicador compuesto.
5.2 Prompts de control neutro (5)
Cinco prompts sobre temas sin relación con la entidad, el sector ni la categoría de uso. Su función es detectar si el modelo introduce la entidad de forma espuria en contextos no pertinentes. No se incluyen en el cálculo de tasas de aparición; se reportan como verificación de especificidad.
5.3 Regla de reporte por categoría
Ningún resultado se presenta agregando las cuatro categorías en una sola tasa. La categoría “validación de marca” se etiqueta siempre como reconocimiento provocado y no se interpreta como evidencia de visibilidad espontánea. Los prompts de control se reportan en una tabla separada.
Nota metodológica. Esta separación responde a una distinción de ERIA™: una cosa es que el sistema exprese contenido sobre una entidad cuando se le pregunta por ella (representación provocada), y otra es que la incluya cuando no se le pregunta por ella (comportamiento de selección espontánea) . Confundir ambas produciría una sobreestimación de la visibilidad espontánea.
6. Modelos y versiones
6.1 Modelos evaluados
Modelo
Proveedor
Interfaz de acceso prevista
ChatGPT
OpenAI
Interfaz web y/o API (se registra cuál)
Gemini
Google
Interfaz web y/o API (se registra cuál)
Claude
Anthropic
Interfaz web y/o API (se registra cuál)
Perplexity
Perplexity AI
Interfaz web (API si disponible y documentada)
6.2 Registro obligatorio de versión
En cada ejecución se registra: nombre del modelo, versión exacta reportada por la interfaz o API, fecha y hora, configuración de búsqueda (on/off), temperatura (si es API), idioma de la interfaz, y cualquier otra configuración accesible. Si la versión no es visible, se registra como “versión no declarada” y se anota como limitación.
6.3 Fuentes de variabilidad no controladas
Se declaran explícitamente: diferencias API vs. web; búsqueda activada o desactivada; temperatura y parámetros de muestreo (API); geolocalización del acceso; idioma de la cuenta o interfaz; personalización por historial de conversación; actualizaciones del modelo durante la ventana de 14 días. Estas fuentes no se controlan experimentalmente; se registran cuando son observables y se tratan como límites de interpretación.
7. Procedimiento de ejecución
7.1 Secuencia por prompt y modelo
Para cada combinación de prompt × modelo se realizan 5 ejecuciones independientes. “Independiente” significa: sesión nueva (sin historial de conversación previo con ese prompt), misma formulación exacta del prompt, y registro de la respuesta RAW completa sin edición.
7.2 Horarios y días
Las 5 ejecuciones de un mismo prompt se distribuyen en al menos 3 días distintos y 2 franjas horarias. La tabla de programación se completa antes de la primera captura y se conserva como registro.
7.3 Registro de incidencias
Toda desviación del procedimiento previsto (fallo de acceso, respuesta truncada, cambio de versión detectado, error de interfaz, interrupción) se registra en la plantilla de ejecución (Anexo A) con marca temporal y descripción. Las incidencias no se eliminan; se reportan en el informe final.
7.4 Tamaño previsto
25 prompts × 4 modelos × 5 ejecuciones = 500 observaciones previstas. Si alguna ejecución falla y no puede repetirse dentro de la ventana, se registra como ausente y se reporta la tasa de finalización.
8. Reglas de codificación
8.1 Codificación binaria primaria
Para cada respuesta RAW se registra:
Aparición limpia (1): la entidad objetivo aparece mencionada de forma identificable y no contaminada por ambigüedad de homonimia, atribución incorrecta a otra entidad, ni contaminación contextual (definida en 8.4).
No aparición limpia (0): la entidad no aparece, o aparece solo en una forma que no permite identificarla inequívocamente conforme a EIDAI™.
8.2 Codificación ordinal de calidad (escala 0–3)
Aplicable solo cuando la codificación binaria es 1 (aparición limpia).
Valor
Etiqueta
Definición operativa
0
Ausencia
No aplica cuando binaria = 0; se reserva para casos de aparición ambigua que no alcanzan mención tangencial.
1
Mención tangencial
La entidad es nombrada, pero sin descripción, contextualización ni recomendación.
2
Alternativa destacada
La entidad es presentada como una opción relevante dentro de una categoría o lista, con al menos una característica o contexto de uso.
3
Recomendación principal
La entidad es recomendada de forma explícita como opción preferente, primera mención en una lista de recomendaciones, o respuesta directa a una solicitud de recomendación.
Nota metodológica. La escala mide calidad de la recomendación en la respuesta, no calidad de la entidad ni adecuación de la recomendación a la realidad. Un 3 significa “el sistema la presentó como recomendación principal”, no “es la mejor opción”.
8.3 Codificación de contexto de uso
Cuando la entidad aparece, se registra el segmento de uso que el sistema le atribuye: (a) monitorización de visibilidad IA; (b) SEO/GEO tradicional; (c) análisis competitivo; (d) otro (especificar); (e) no especificado. Esta codificación es descriptiva y no se agrega en un índice.
8.4 Regla de exclusión de apariciones contaminadas (EIDAI™)
Una aparición se considera contaminada y se excluye de la codificación binaria limpia si concurre al menos una de las siguientes condiciones:
Homonimia no resuelta: el sistema reconoce el nombre pero no permite determinar si se refiere a la entidad objetivo u otra entidad con nombre similar.
Atribución incorrecta: el sistema atribuye a la entidad objetivo características, productos o relaciones que corresponden a otra entidad según la ficha de identidad de referencia.
Contaminación contextual: la respuesta incorpora referencias explícitas al investigador, a los marcos AVM™/PCI™/MEIA™, o a la conversación previa, de modo que la mención de la entidad puede estar influida por ese contexto y no por el prompt.
Las apariciones contaminadas se registran como Aparición contaminada (A) y se reportan por separado. No se eliminan de la base de datos. Se conservan en el RAW y se anotan con el tipo de contaminación.
9. Garantías de fiabilidad
9.1 Preregistro público
Antes de la primera captura, la versión 0.1 de este protocolo se depositará en un servicio de sellado de tiempo externo (por ejemplo, un registro con hash público o un repositorio con fecha verificable). El hash del documento y la fecha de depósito se registrarán en el Anexo D.
9.2 Doble codificación ciega
Si se dispone de dos codificadores, la codificación de la escala ordinal (0–3) se realizará de forma ciega e independiente sobre una muestra del 100% de las respuestas con aparición limpia. El acuerdo se calculará mediante Kappa de Cohen, exclusivamente para la escala ordinal. La codificación binaria primaria no se someterá a Kappa porque su regla es determinista y verificable contra el RAW; las discrepancias se resolverán por referencia a la regla, no por consenso estadístico.
9.3 Intervalos de confianza
Los intervalos de confianza se calcularán agrupados por prompt, no sobre el total de 500 registros. Para cada prompt, la unidad de agregación es el conjunto de 5 ejecuciones. No se reportarán intervalos de confianza sobre el total de observaciones como si fueran independientes.
9.4 Registro de versiones y cambios
Cualquier modificación del protocolo después del preregistro genera una nueva versión (0.2, 0.3, etc.) y se documenta en la tabla de versiones (Anexo D). No se sobrescribe silenciosamente una versión anterior. Si un cambio se produce después de conocer resultados parciales, se declara explícitamente en la nueva versión.
10. Análisis previsto
10.1 Métricas por dimensión de AVM™
Dimensión AVM™
Métrica operativa en NEXARA
Nivel de reporte
Frecuencia de aparición
Proporción de ejecuciones con aparición limpia (1) por prompt
Por prompt y por modelo
Cobertura entre modelos
Número de modelos en los que la entidad aparece limpiamente en al menos 4/5 ejecuciones del mismo prompt
Por prompt
Consistencia intra-prompt
Número de ejecuciones con el mismo valor binario (1 o 0) dentro de un prompt
Por prompt y modelo
Contexto de aparición
Distribución de segmentos de uso (8.3)
Descriptivo, por categoría de prompt
Calidad de recomendación
Distribución de valores ordinales 0–3 en apariciones limpias
Por categoría de prompt y modelo
10.2 Reporte separado por categoría
Ninguna tabla ni figura agrega las cuatro categorías experimentales en un solo valor. La categoría “validación de marca” se presenta en sección propia y etiquetada como reconocimiento provocado. Los controles neutros se presentan en sección separada como verificación de especificidad.
10.3 Comparación con baseline de persistencia (PCI™)
En Fase 0, no se ejecuta validación predictiva. Lo que se preregistra es la regla que se aplicaría en una fase posterior: el baseline de persistencia PB0.1 asume que el estado observado en una oleada Tn se mantiene en Tn+1. Cualquier comparación futura entre una señal y este baseline requerirá que la predicción se registre y bloquee antes de observar Tn+1 . En Fase 0 no hay Tn+1, por lo que no hay comparación posible. Esta sección existe para dejar constancia de que la lógica de PCI™ no se confunde con los resultados observacionales de Fase 0.
10.4 Análisis secundario exploratorio
Cualquier análisis no preregistrado (por ejemplo, comparaciones post hoc entre modelos, correlaciones entre categorías) se etiqueta como exploratorio en el informe y no se utiliza para apoyar o rechazar H1. Se reporta con la misma trazabilidad que el análisis primario, pero con la advertencia explícita de que no estaba previsto antes de la captura.
11. Limitaciones declaradas desde el inicio
Un solo caso no permite generalización sectorial. NEXARA observa una entidad en un corpus acotado. Los resultados no describen “la visibilidad de las marcas en IA” ni “el comportamiento de los modelos” en general.
La ventana de 14 días captura un estado, no una tendencia. Cualquier estabilidad observada es estabilidad dentro de esa ventana. No se infiere persistencia más allá de ella.
La codificación binaria simplifica la riqueza de las respuestas. Una respuesta puede contener matices que la escala 0–3 no captura. La codificación ordinal mitiga parcialmente esta limitación, pero no la elimina.
PCI™ no se valida en Fase 0; solo se preregistra. No se afirma capacidad predictiva. La lógica de comparación con baseline queda documentada para fases posteriores, no ejecutada.
Los modelos cambian sin aviso. Una actualización durante la ventana de 14 días puede alterar el comportamiento observado. El registro de versiones detecta el cambio si es visible, pero no lo controla.
La variabilidad no controlada (API vs. web, búsqueda on/off, personalización) limita la comparabilidad exacta entre ejecuciones. Se registra cuando es observable; no se elimina.
La aparición contaminada se reporta pero no se “corrige”. La exclusión de la codificación limpia no recupera la respuesta original; solo la clasifica. El RAW se conserva para auditoría.
12. Gobernanza y datos
12.1 Política de datos
Se publicarán: (a) el protocolo versionado; (b) las respuestas RAW completas, con marcas temporales y metadatos de ejecución; (c) la matriz de codificación; (d) el registro de anomalías; (e) el informe de resultados con las limitaciones. Los datos se publicarán en formato abierto (CSV/JSON para datos estructurados; TXT/JSON para respuestas RAW) bajo licencia CC BY 4.0 para el protocolo y los datos, salvo que la interfaz de algún modelo imponga restricciones de redistribución de sus respuestas, en cuyo caso se publicarán los extractos codificados y las instrucciones para que un tercero reproduzca la captura.
12.2 Repositorio previsto
El repositorio aún no existe en la fecha de esta versión. La versión 0.1 preregistra la estructura prevista: un directorio raíz con subdirectorios para protocolo, RAW, codificación, anomalías, análisis e informes. La URL del repositorio se añadirá en la versión 0.2 antes de la captura.
12.3 Anonimización
No se prevé anonimización de respuestas de modelos, porque no contienen datos personales de terceros. Si una respuesta incluyera datos personales por generación espontánea del modelo, se registrará el incidente y se evaluará caso por caso si procede la publicación del RAW completo o de un extracto con el dato personal redactado, conservando el RAW íntegro en un archivo restringido para auditoría.
12.4 Revisión y versionado
Este protocolo puede ser revisado por un tercero independiente antes del preregistro. Las revisiones se incorporan como versiones sucesivas. La versión que se sella con tiempo externo es la que rige la ejecución. Cualquier cambio posterior se documenta como versión nueva con justificación.
13. Referencias documentales
Glosario canónico AVM™: https://www.manuduque.com/glosario-canonico-avm/
AVM™ — AI Visibility Model: https://www.manuduque.com/ai-visibility-model-avm/
EIDAI™ — Entity Identification and Disambiguation in AI: https://www.manuduque.com/eidai-entity-identification-and-disambiguation-in-artificial-intelligence/
ERIA™ — Entity Representation in AI: https://www.manuduque.com/eria-entity-representation-in-ai/
PCI™ — Longitudinal Research Architecture: https://www.manuduque.com/pci-longitudinal-research-architecture-0-1/
PCI-L01 — Prospectively Locked Prediction Protocol 0.1: https://www.manuduque.com/pci-l01-prospectively-locked-prediction-protocol-0-1/
MEIA™ — Diseño del sistema de evidencia y verificación: https://www.manuduque.com/meia-diseno-del-sistema-de-evidencia-y-verificacion-ia/
MEIA™ — Arquitectura modular: https://www.manuduque.com/meia-arquitectura-modular-del-sistema-metodologico/
Prevalencia interpretativa. Las definiciones vigentes en el glosario canónico y en las páginas de cada marco prevalecen sobre cualquier formulación operativa contenida en este protocolo. Si una regla de este documento entra en conflicto con una definición canónica, se aplicará la definición canónica y se registrará la discrepancia para su resolución en la siguiente versión.
14. Anexos
Anexo A — Plantilla de registro de ejecución
Campo
Valor
ID de ejecución
NEXARA-F0-{prompt}-{modelo}-{rep}
Prompt ID
P01–P25
Categoría
Descubrimiento / Comparación / Resolución / Validación / Control
Modelo
ChatGPT / Gemini / Claude / Perplexity
Versión declarada
(texto)
Interfaz
Web / API
Búsqueda
On / Off / No aplica
Fecha y hora
ISO 8601 con zona horaria
Respuesta RAW
Archivo vinculado
Incidencia
Ninguna / (descripción)
Codificación binaria
1 / 0 / A
Codificación ordinal
0 / 1 / 2 / 3 / No aplica
Contexto de uso
(a)–(e)
Anexo B — Plantilla de ficha de identidad (EIDAI™)
Campo
Contenido
Entidad objetivo
(nombre oficial)
Denominaciones reconocidas
(lista)
Identificadores
(dominio, razón social si aplica)
Categoría de actividad
(definición operativa)
Productos/servicios verificables
(lista con fuente)
Entidades con nombre similar
(lista y criterio de distinción)
Fuente de referencia
(documento o URL que respalda cada dato)
Fecha de la ficha
(ISO 8601)
Anexo C — Plantilla de codificación ordinal
Respuesta ID
Aparición binaria
Valor ordinal
Justificación (extracto del RAW)
Codificador
Fecha
(ID)
1
0–3
(cita literal mínima)
(inicial)
(ISO)
Anexo D — Tabla de versiones del protocolo
Versión
Fecha
Cambio
Estado
0.1
14/11/2026
Versión inicial para revisión
Borrador
(pendiente)
(pendiente)
(pendiente)
(pendiente)
Estado del documento
Versión: 0.1
Fecha: 14 de noviembre de 2026
Estado: Borrador para revisión metodológica. No congelado. No apto para ejecución hasta que se complete el preregistro con sello de tiempo externo y se designe la ficha de identidad de la entidad objetivo.
Próximos pasos previstos:
Revisión por un tercero independiente (metodología y claridad de reglas).
Incorporación de observaciones y emisión de versión 0.2.
Cumplimentación del Anexo B (ficha de identidad) y designación de los 25 prompts finales.
Depósito del protocolo 0.2 con sello de tiempo externo y registro del hash.
Inicio de la captura de Fase 0 solo después de los pasos 3 y 4.