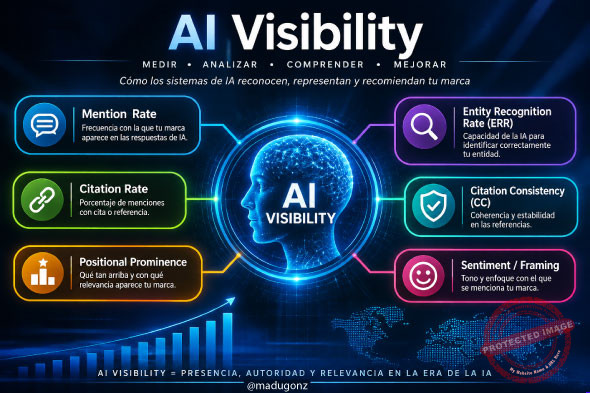
Qué medir en AI Visibility: las 6 métricas clave para el reconocimiento y descubrimiento de una entidad.
Mención, citación, prominencia, reconocimiento, consistencia y representación: cómo evaluar si la IA reconoce, descubre y representa bien tu entidad.
La visibilidad ya no se juega solo en buscadores.
Cada vez más personas preguntan a modelos de IA qué producto elegir, qué marca es fiable o quién lidera un sector, y obtienen respuestas sintetizadas que mencionan, citan y posicionan entidades concretas.
En ese nuevo entorno, aparecer no es lo mismo que ser reconocido, y ser mencionado no equivale a ser recomendado.
La AI Visibility exige medir con rigor cómo la IA reconoce una entidad, la descubre en contextos relevantes y la representa con exactitud.
Qué medir. Para saber cómo la IA reconoce y descubre una entidad no basta con contar menciones aisladas; hay que evaluar seis dimensiones complementarias.
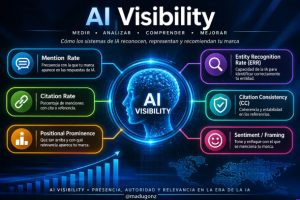
La tasa de mención con qué frecuencia aparece, la tasa de citación con qué frecuencia se usa como fuente, la prominencia posicional en qué lugar de la respuesta aparece, el reconocimiento de entidad si el modelo la identifica correctamente como objeto del mundo real, la consistencia de citación si las fuentes se mantienen estables en el tiempo y entre prompts y el sentimiento y representación con qué tono y con qué exactitud se la describe, incluyendo la tasa de alucinación.
La lectura conjunta de estas métricas permite responder a una pregunta más útil que el simple recuento de apariciones.
¿la IA habla bien de la entidad, la cita con autoridad, la posiciona con prominencia y mantiene una representación fiable?
A lo largo de las siguientes secciones se define cada métrica, se propone cómo calcularla e interpretarla, y se explica cómo operativizarlas en un dashboard de AI Visibility con línea base, evolución temporal y alertas.
Porque en la era de las respuestas generativas, medir lo correcto es la diferencia entre ruido y visibilidad real.
📊 Qué medir: métricas clave para el reconocimiento y descubrimiento en AI Visibility
En AI Visibility no basta con “aparecer”: hay que medir si la IA reconoce la entidad, la descubre en respuestas relevantes, la cita como fuente, la posiciona con prominencia, mantiene consistencia y la representa con exactitud.
Estas métricas deben medirse por modelo, idioma, tipo de prompt y fecha, usando un conjunto estable de prompts de alto valor.
📣 Tasa de Mención – Mention Ratio
Qué mide: la frecuencia con la que la entidad aparece mencionada, al menos una vez, en las respuestas a un conjunto de prompts de alto valor.
Fórmula básica:
Mention Ratio = respuestas con mención / total de respuestas válidas
Cómo medirlo: definir la entidad y sus alias; ejecutar prompts representativos informacionales, comparativos, de compra, de recomendación; detectar menciones exactas y variantes; segmentar por modelo, idioma, intención y fecha.
Interpretación: indica el nivel básico de descubrimiento y awareness en respuestas generativas.
Una tasa alta de mención no implica recomendación, citación ni buena posición.
Ejemplo: si 40 de 100 respuestas mencionan la marca, el Mention Ratio es del 40 %
📣 Ejemplo práctico: Tasa de Mención – Mention Ratio
Contexto del caso
Imaginemos una marca ficticia de software de gestión de proyectos llamada «Planify», que quiere saber cómo de visible es en las respuestas de IA frente a sus competidores.
Para ello, diseña un prompt set de alto valor de 50 preguntas representativas, agrupadas por intención:
Informacional 15 prompts: «¿qué es Planify?», «¿qué herramientas de gestión de proyectos existen?»
Comparativa 15 prompts: «Planify vs Asana», «mejores alternativas a Trello»
Transaccional/recomendación 10 prompts: «¿qué software de gestión de proyectos me recomiendas para un equipo pequeño?»
Reputacional 10 prompts: «¿es fiable Planify?», «¿qué opinan los usuarios de Planify?»
Cada prompt se ejecuta en 3 modelos distintos (por ejemplo, ChatGPT, Gemini y Claude) y en un único idioma, con 1 ejecución por modelo y prompt. Total: 150 respuestas válidas.
Paso 1: Definir la entidad y sus alias
Antes de contar, hay que saber qué se busca. Para Planify se definen:
Menciones exactas: «Planify»
Variantes y alias: «Planify App», «Planify Software», «planify.com»
Falsos positivos a excluir: «Planificar» (verbo), «Planify Pro» si se decidiera medir como producto separado
Paso 2: Ejecutar y clasificar las respuestas
Se lanzan los 50 prompts en los 3 modelos y se revisan las 150 respuestas. El resultado del recuento es:
| Resultado | Nº de respuestas | % sobre total |
| Respuestas con mención de Planify | 42 | 28 % |
| Respuestas sin mención | 108 | 72 % |
| Total | 150 | 100 % |
Cálculo:
Mention Ratio = 42 / 150 = 0,28 → 28 %
Paso 3: Segmentar para entender el dato
Un 28 % global dice poco por sí solo. Se desglosa por intención y por modelo:
| Intención | Respuestas | Con mención | Mention Ratio |
| Informacional | 45 | 18 | 40 % |
| Comparativa | 45 | 15 | 33 % |
| Transaccional | 30 | 6 | 20 % |
| Reputacional | 30 | 3 | 10 % |
| Total | 150 | 42 | 28 % |
| Modelo | Respuestas | Con mención | Mention Ratio |
| ChatGPT | 50 | 17 | 34 % |
| Gemini | 50 | 14 | 28 % |
| Claude | 50 | 11 | 22 % |
Paso 4: Interpretar el resultado
El 28 % global es solo el punto de partida. Planify aparece en casi 3 de cada 10 respuestas, pero el dato esconde una gran variación.
Fortaleza informacional 40 %: la IA sabe qué es Planify y la incluye cuando se pregunta por el sector. Hay reconocimiento básico.
Debilidad transaccional 20 % y reputacional 10 %: cuando el usuario pide una recomendación concreta o pregunta por fiabilidad, Planify casi desaparece.
Es decir, se la conoce, pero no se la recomienda ni se la valida.
Brecha entre modelos 34 % vs 22 %: la visibilidad no es homogénea; Claude menciona menos a Planify, lo que puede indicar menor cobertura de fuentes o de datos estructurados en ese modelo.
Paso 5: Convertir el dato en acción
El Mention Rateo aislado no responde a «¿por qué?». Por eso se cruza con las otras métricas:
Citation Rateo bajo en prompts transaccionales → la IA menciona Planify pero no la usa como fuente; falta autoridad editorial comparativas, reviews, casos de uso.
Positional Prominence baja en comparativas → cuando aparece, lo hace en párrafos secundarios, no en el top de la lista.
Entity Recognition alto pero Sentiment neutro → la entidad se identifica bien, pero no se asocia a atributos diferenciales que disparen la recomendación.
Acciones derivadas del ejemplo:
Crear contenido comparativo y de casos de uso que los modelos puedan citar en prompts transaccionales.
Reforzar presencia en fuentes que la IA usa para recomendaciones directorios, reviews, medios sectoriales.
Repetir la medición mensualmente para ver si el Mention Ratio transaccional sube del 20 % al 35 % tras las acciones.
✅ Lectura final del ejemplo
El Mention Ratio del 28 % no significa «somos poco visibles» ni «somos muy visibles»: significa que la IA reconoce a Planify en contextos informativos, pero no la descubre ni la recomienda en contextos de decisión.
Esa es exactamente la utilidad de la métrica: convertir un recuento de apariciones en un diagnóstico accionable, siempre que se lea segmentada y junto al resto de dimensiones de AI Visibility.
🔗 Tasa de Citación – Citation Ratio
Qué mide: la frecuencia con la que la entidad es citada como fuente, ya sea mediante enlace, dominio, atribución textual o referencia explícita.
Fórmula básica:
iCitation Rato = respuestas con cita atribuida a la entidad / total de respuestas válidas
También puede calcularse como citas / menciones.
Cómo medirlo: separar mención de citación; identificar enlaces, dominios, nombres de fuente y atribuciones textuales; distinguir cita directa, fuente consultada y simple referencia.
Es clave no confundir “hablar de la marca” con “usar la marca como fuente”.
Interpretación: mide autoridad y capacidad de ser fuente consultada por el modelo.
Una alta mención con baja citación sugiere visibilidad sin respaldo de autoridad; una citación alta con mención baja puede indicar que la entidad es fuente pero no protagonista.
🔗 Ejemplo práctico: Tasa de Citación – Citation Ratio
Contexto del caso
Continuamos con Planify, la marca ficticia de software de gestión de proyectos.
En el ejemplo anterior medimos su Mention Ratio 28 %: aparece en 42 de 150 respuestas, pero sobre todo en contextos informativos y poco en los transaccionales.
Ahora queremos saber algo distinto y más exigente: ¿cuándo la IA usa a Planify como fuente?
Es decir, no solo si habla de la marca, sino si la cita, la enlaza o la atribuye como referencia.
Para ello reutilizamos el mismo prompt set de 50 preguntas ejecutado en 3 modelos ChatGPT, Gemini, Claude, con un total de 150 respuestas válidas.
Así podemos comparar mención y citación sobre la misma base.
Paso 1: Definir qué cuenta como citación
Antes de medir hay que fijar criterios. Para Planify se considera citación cuando en la respuesta aparece al menos uno de estos elementos:
Enlace directo al dominio de la entidad: planify.com, blog.planify.com
Atribución textual explícita: «según Planify…», «de acuerdo con la documentación de Planify…»
Referencia a fuente identificable: nombre del informe, estudio o página de Planify usado como respaldo
No se considera citación:
Una mención sin enlace ni atribución «Planify es una opción…»
Un enlace a un tercero que habla de Planify eso sería fuente sobre la entidad, no fuente de la entidad
Esta distinción es clave: mención ≠ citación.
Paso 2: Ejecutar y clasificar las respuestas
Se revisan las 150 respuestas y se registra, para cada una, si hay mención, si hay citación y de qué tipo:
| Resultado | Nº de respuestas | % sobre total |
| Respuestas con mención de Planify | 42 | 28 % |
| Respuestas con citación de Planify | 12 | 8 % |
| Respuestas con mención pero sin citación | 30 | 20 % |
| Respuestas sin mención ni citación | 108 | 72 % |
| Total | 150 | 100 % |
Cálculos:
Citation Rateo sobre total de respuestas = 12 / 150 = 0,08 → 8 %
Citation Ratio sobre menciones = 12 / 42 = 0,286 → 28,La segunda fórmula es especialmente útil: indica que de cada 100 veces que la IA menciona a Planify, solo en 29 la cita como fuente. El resto son menciones «sin respaldo».
Paso 3: Segmentar por intención y por modelo
Un 8 % global oculta diferencias relevantes. Desglosamos:
| Intención | Respuestas | Menciones | Citaciones | Citation Ratio (sobre respuestas) | Citation Ratio (sobre menciones) |
| Informacional | 45 | 18 | 6 | 13,3 % | 33,3 % |
| Comparativa | 45 | 15 | 4 | 8,9 % | 26,7 % |
| Transaccional | 30 | 6 | 1 | 3,3 % | 16,7 % |
| Reputacional | 30 | 3 | 1 | 3,3 % | 33,3 % |
| Total | 150 | 42 | 12 | 8 % | 28,6 % |
| Modelo | Respuestas | Menciones | Citaciones | Citation Rateo (sobre respuestas) |
| ChatGPT | 50 | 17 | 5 | 10 % |
| Gemini | 50 | 14 | 4 | 8 % |
| Claude | 50 | 11 | 3 | 6 % |
Paso 4: Interpretar el resultado
Brecha mención–citación 28 % vs 8 %: la IA habla de Planify con frecuencia, pero rara vez la usa como fuente.
Esto sugiere visibilidad sin autoridad: se la conoce, pero no se la consulta.
Mejor citación en informacional 33,3 % sobre menciones: cuando el usuario pregunta «qué es» o «qué herramientas existen», el modelo sí recurre a la documentación de Planify.
Hay reconocimiento y fuente disponible.
Citación débil en transaccional 16,7 % sobre menciones: en el momento de la decisión, la IA no respalda su recomendación con Planify; probablemente se apoya en reviews, comparativas de terceros o directorios. Ahí falta contenido citable propio.
Brecha entre modelos 10 % vs 6 %: Claude cita menos a Planify, lo que puede indicar que su índice de fuentes no incluye tanto contenido de la marca o que prioriza otras referencias.
Paso 5: Convertir el dato en acción
El Citation Ratio aislado tampoco responde al «por qué».
Se cruza con las demás métricas:
Mention Ratio alto + Citation Ratio bajo → la entidad es conocida pero no es autoridad.
Acción: crear contenido estructurado, documentación técnica, guías y casos de uso con datos verificables que los modelos puedan citar.
Citation Ratio bajo en transaccional → falta presencia en fuentes que la IA usa para recomendar directorios, comparativas, reviews.
Acción: trabajar earned media y listados sectoriales.
Citation Consistency a medir → comprobar si las 12 citaciones apuntan siempre a las mismas URLs o si varían; si varían mucho, la autoridad no está consolidada.
Acciones derivadas del ejemplo:
Publicar páginas de referencia citables documentación, estudios propios, comparativas con datos.
Reforzar la presencia en fuentes de terceros que los modelos usan en prompts transaccionales.
Repetir la medición mensualmente y fijar objetivo: subir el Citation Rateo sobre menciones del 28,6 % al 40 % en seis meses.
✅ Lectura final del ejemplo
El Citation Rateo del 8 % o del 28,6 % sobre menciones revela algo que el Mention Ratio no mostraba: Planify es mencionada, pero no es fuente.
La IA la reconoce como entidad, pero no la utiliza como respaldo de sus respuestas.
Esa diferencia entre «hablar de» y «citar a» es exactamente lo que mide esta métrica, y su lectura segmentada por intención, por modelo y junto a mención y prominencia convierte el dato en un diagnóstico accionable sobre autoridad y confianza en AI Visibility.
📍 Prominencia Posicional – Positional Prominence
Qué mide: el lugar y la jerarquía que ocupa la entidad dentro de la respuesta: primera mención, aparición en una lista ordenada, recomendación principal, párrafo secundario o mención residual.
Cómo medirlo: codificar la posición ordinal de la primera mención; registrar si aparece en listas, tablas o comparativas; asignar pesos por posición por ejemplo, primera mención > top 3 > párrafo secundario > mención final; calcular promedio, mediana y distribución de posiciones.
Interpretación: no es lo mismo ser mencionado al final que ser recomendado en primer lugar.
La prominencia influye en percepción, recordación y probabilidad de elección.
Debe analizarse junto con sentimiento y exactitud.
📍 Ejemplo práctico: Prominencia Posicional – Positional Prominence
Contexto del caso
Seguimos con Planify, la marca ficticia de software de gestión de proyectos.
Ya sabemos que su Mention Ratio es del 28 % y su Citation Ratio del 8 %: aparece, pero rara vez como fuente.
Ahora queremos responder a una pregunta distinta: cuando la IA la menciona, ¿en qué lugar de la respuesta lo hace? No es lo mismo ser la primera recomendación de una lista que una mención residual al final de un párrafo.
Para ello reutilizamos el mismo prompt set de 50 preguntas en 3 modelos ChatGPT, Gemini, Claude, con 150 respuestas válidas y 42 respuestas con mención de Planify. Sobre esas 42 menciones vamos a medir la prominencia posicional.
Paso 1: Definir la escala de prominencia
Antes de medir hay que fijar una escala operativa.
Para Planify se establece la siguiente jerarquía, con pesos asignados:
| Nivel | Descripción | Peso |
| P1 — Primera mención | Planify es la primera entidad nombrada en la respuesta | 5 |
| P2 — Top de lista | Aparece en una lista ordenada en posición 1–3 | 4 |
| P3 — Lista secundaria | Aparece en lista en posición 4 o posterior | 3 |
| P4 — Párrafo principal | Se la menciona en el cuerpo principal, sin lista | 2 |
| P5 — Mención residual | Aparece al final, en una nota o como ejemplo menor | 1 |
Puntuación de prominencia: se calcula la media ponderada de los pesos sobre las menciones.
Un valor cercano a 5 indica prominencia máxima; cercano a 1, prominencia mínima.
Paso 2: Ejecutar y clasificar las menciones
Se revisan las 42 respuestas con mención y se asigna un nivel de prominencia a cada una:
| Nivel | Nº de menciones | % sobre menciones |
| P1 — Primera mención | 3 | 7,1 % |
| P2 — Top de lista | 6 | 14,3 % |
| P3 — Lista secundaria | 9 | 21,4 % |
| P4 — Párrafo principal | 12 | 28,6 % |
| P5 — Mención residual | 12 | 28,6 % |
| Total | 42 | 100 % |
Cálculo de la prominencia media ponderada:
(3×5 + 6×4 + 9×3 + 12×2 + 12×1) / 42 = (15 + 24 + 27 + 24 + 12) / 42 = 102 / 42 ≈ 2,43
Prominencia media = 2,43 sobre 5 → ligeramente por debajo del punto medio.
Planify aparece, pero no suele ocupar los lugares destacados.
Paso 3: Segmentar por intención y por modelo
El dato global esconde diferencias que cambian el diagnóstico. Desglosamos:
| Intención | Menciones | Prominencia media | % en P1–P2 |
| Informacional | 18 | 2,72 | 27,8 % |
| Comparativa | 15 | 2,20 | 13,3 % |
| Transaccional | 6 | 2,00 | 16,7 % |
| Reputacional | 3 | 1,67 | 0 % |
| Total | 42 | 2,43 | 21,4 % |
| Modelo | Menciones | Prominencia media | % en P1–P2 |
| ChatGPT | 17 | 2,65 | 29,4 % |
| Gemini | 14 | 2,43 | 21,4 % |
| Claude | 11 | 2,09 | 9,1 % |
Paso 4: Interpretar el resultado
Prominencia media baja 2,43/5: Planify aparece, pero casi nunca en la primera posición ni en el top de una lista.
El 57,2 % de sus menciones son de nivel P4–P5 párrafo secundario o residual. Es decir, se la conoce, pero no se la destaca.
Mejor prominencia informacional 2,72: cuando el usuario pregunta «qué herramientas existen», Planify suele estar en el cuerpo principal.
Hay reconocimiento, pero no liderazgo.
Peor prominencia comparativa 2,20 y reputacional 1,67: en los contextos de decisión «Planify vs Asana», «¿es fiable?» la marca cae a posiciones secundarias o residuales.
Esto explica por qué su Citation Ratio transaccional era bajo: no está en el top, así que no se usa como fuente principal.
Brecha entre modelos 2,65 vs 2,09: Claude no solo menciona menos a Planify, sino que la posiciona peor.
La visibilidad no es homogénea y la prominencia tampoco.
Paso 5: Convertir el dato en acción
La prominencia aislada no responde al «por qué». Se cruza con las otras métricas:
Prominencia baja + Citation Ratio bajo → la entidad no es ni destacada ni fuente.
Acción: crear contenido que los modelos puedan usar como referencia principal en comparativas tablas, datos verificables, casos de uso.
Prominencia baja en comparativas → la IA no ve a Planify como líder ni como alternativa fuerte.
Acción: reforzar señales de autoridad (reviews, menciones en medios, comparativas de terceros.
Prominencia baja en reputacional → la marca no se asocia a fiabilidad.
Acción: trabajar prueba social y contenido de confianza.
Acciones derivadas del ejemplo:
Publicar comparativas propias con datos estructurados que los modelos puedan citar y posicionar.
Reforzar la presencia en fuentes que la IA usa en prompts comparativos y transaccionales.
Fijar objetivo: subir la prominencia media de 2,43 a 3,20 en seis meses, y el % en P1–P2 del 21,4 % al 35 %
✅ Lectura final del ejemplo
La prominencia media de 2,43 sobre 5 y el hecho de que solo el 21,4 % de las menciones estén en primeras posiciones revelan algo que ni el Mention Ratio ni el Citation Ratio mostraban: Planify aparece, pero no destaca.
La IA la reconoce como entidad, la menciona en contextos informativos, pero no la coloca en el top ni la usa como referencia principal cuando el usuario decide.
Esa diferencia entre «aparecer» y «destacar» es exactamente lo que mide la prominencia posicional, y su lectura segmentada por intención, por modelo y junto a mención y citación convierte el dato en un diagnóstico accionable sobre liderazgo y percepción en AI Visibility.
🧠 Reconocimiento de Entidad – Entity Recognition Ratio, ERR
Qué mide: la consistencia con la que el modelo identifica correctamente la entidad como un objeto del mundo real sobre el que tiene información, sin confundirla con homónimos, negar su existencia o atribuirle datos erróneos.
Fórmula básica:
ERR = evaluaciones con identificación correcta / total de evaluaciones
Cómo medirlo: formular preguntas directas “¿qué es X?”, “¿quién es X?”, “¿qué hace X?”; verificar desambiguación frente a entidades similares; comprobar atributos básicos; repetir en varios modelos e idiomas.
Interpretación: un ERR bajo señala problemas de entidad: ambigüedad de nombre, falta de datos estructurados, poca autoridad, escasa cobertura o confusión con otras entidades.
Es una métrica previa a la visibilidad: si la IA no reconoce bien la entidad, difícilmente la descubrirá y citará correctamente.
🧠 Ejemplo práctico: Reconocimiento de Entidad – Entity Recognition Ratio, ERR
Contexto del caso
Seguimos con Planify, la marca ficticia de software de gestión de proyectos.
Hasta ahora sabemos que su Mention Ratio es del 28 %, su Citation Ratio del 8 % y su prominencia media de 2,43 sobre 5: aparece, pero no como fuente ni en lugares destacados.
Antes de seguir midiendo visibilidad, hay una pregunta previa y más fundamental: ¿la IA sabe realmente qué es Planify?
Es decir, ¿la identifica correctamente como una entidad del mundo real, sin confundirla, negarla o inventarle atributos?
Para ello diseñamos un entity prompt set específico, distinto del prompt set de visibilidad: preguntas directas y de desambiguación sobre la entidad, ejecutadas en los 3 modelos habituales ChatGPT, Gemini, Claude.
Paso 1: Definir qué cuenta como reconocimiento correcto
Antes de medir hay que fijar criterios.
Para Planify se define la ficha de entidad de referencia ground truth:
Tipo: software de gestión de proyectos
Categoría: SaaS B2B
Fundación: 2019
Sede: Barcelona
Atributos clave: tableros Kanban, integración con Slack, plan gratuito, enfoque en equipos pequeños
Entidad propietaria: empresa Planify Inc.
Una respuesta cuenta como reconocimiento correcto si el modelo:
Identifica a Planify como el software de gestión de proyectos no como otra entidad
No la confunde con homónimos ni con competidores
Acierta al menos el 80 % de los atributos básicos verificables
No niega su existencia ni la declara obsoleta o inexistente
Paso 2: Diseñar el entity prompt set
Se construyen 30 prompts específicos de reconocimiento, agrupados en 3 bloques de 10:
| Bloque | Objetivo | Ejemplos de prompts |
| Identificación directa | ¿Sabe qué es? | «¿Qué es Planify?», «¿A qué se dedica Planify?» |
| Desambiguación | ¿La distingue de otras? | «¿Planify es lo mismo que Planful?», «¿Planify es una app de finanzas?» |
| Verificación de atributos | ¿Acierta los datos? | «¿Cuándo se fundó Planify?», «¿Qué integraciones tiene Planify?» |
Se ejecutan en 3 modelos → 90 respuestas válidas para evaluar ERR.
Paso 3: Ejecutar y clasificar las respuestas
Se revisan las 90 respuestas y se clasifica cada una según el criterio de reconocimiento:
| Resultado | Nº de respuestas | % sobre total |
| Reconocimiento correcto | 63 | 70 % |
| Reconocimiento parcial (identifica pero falla atributos) | 15 | 16,7 % |
| Confusión con otra entidad | 9 | 10 % |
| No reconocimiento / niega existencia | 3 | 3,3 % |
| Total | 90 | 100 % |
Cálculo:
ERR = 63 / 90 = 0,70 → 70 %
Si se quiere un ERR estricto (solo reconocimiento completo):
ERR estricto = 63 / 90 = 70 %
ERR ampliado correcto + parcial = 63 + 15 / 90 = 86,7 %
Paso 4: Segmentar para entender el dato
Un 70 % global oculta diferencias relevantes. Desglosamos por bloque y por modelo:
| Bloque | Respuestas | Correctas | ERR |
| Identificación directa | 30 | 27 | 90 % |
| Desambiguación | 30 | 18 | 60 % |
| Verificación de atributos | 30 | 18 | 60 % |
| Total | 90 | 63 | 70 % |
| Modelo | Respuestas | Correctas | ERR |
| ChatGPT | 30 | 23 | 76,7 % |
| Gemini | 30 | 21 | 70 % |
| Claude | 30 | 19 | 63,3 % |
Errores detectados con más frecuencia:
| Error | Nº de casos | Ejemplo |
| Confusión con Planful (software financiero) | 6 | «Planify es una plataforma de planificación financiera…» |
| Confusión con Planable (gestión de redes sociales) | 3 | «Planify ayuda a programar publicaciones en redes…» |
| Atributos incorrectos (fundación, sede, integraciones) | 15 | «Planify se fundó en 2015 en Madrid…» |
| Niega existencia | 3 | «No tengo información sobre Planify» |
Paso 5: Interpretar el resultado
ERR del 70 %: la IA reconoce a Planify en 7 de cada 10 respuestas, pero 3 de cada 10 fallan en identificación, desambiguación o atributos.
Es un ERR medio-bajo: hay reconocimiento, pero no consolidado.
Identificación directa alta 90 %: cuando se pregunta «¿qué es?», el modelo acierta casi siempre.
La entidad existe en su conocimiento.
Desambiguación débil 60 %: el 40 % de las respuestas confunden Planify con Planful o Planable.
Esto es crítico: si la IA no distingue la entidad de sus homónimos, la visibilidad se contamina y las métricas de mención y citación pueden estar infladas o mal atribuidas.
Atributos flojos 60 %: fundación, sede e integraciones se fallan con frecuencia. La IA tiene una representación parcial y posiblemente desactualizada de la entidad.
Brecha entre modelos 76,7 % vs 63,3 %: Claude reconoce peor a Planify, lo que sugiere menor cobertura de fuentes o de datos estructurados en ese modelo.
Paso 6: Convertir el dato en acción
El ERR aislado no responde al «por qué». Se cruza con las otras métricas:
ERR bajo + Mention Ratio alto → la IA menciona a Planify, pero a veces confundida con otra entidad.
Riesgo: menciones contaminadas y atribución errónea.
Acción: reforzar señales de desambiguación nombre completo, dominio, datos estructurados, sameAs en schema.org.
ERR bajo en atributos + Citation Rato bajo → la IA no tiene fuentes fiables de la entidad.i
Acción: publicar datos verificables y actualizados página «About», ficha de empresa, Wikipedia/Wikidata si aplica.
ERR bajo en desambiguación → trabajar la diferenciación explícita frente a homónimos en el contenido propio y en fuentes de terceros.
Acciones derivadas del ejemplo:
Implementar datos estructurados de la entidad schema.org Organization, sameAs, foundingDate, headquarters.
Crear una página de referencia canónica con atributos verificables y actualizados.
Publicar contenido que desambigüe explícitamente frente a Planful y Planable.
Repetir la medición mensualmente y fijar objetivo: subir el ERR del 70 % al 85 % en seis meses, y la desambiguación del 60 % al 80 %
✅ Lectura final del ejemplo
El ERR del 70 % revela algo que las métricas anteriores no mostraban: la IA no siempre sabe quién es Planify.
La confunde con homónimos en 1 de cada 10 respuestas y falla atributos básicos en casi 4 de cada 10.
Esa debilidad de reconocimiento contamina la mención, la citación y la prominencia: si la entidad no está bien identificada, el resto de métricas de AI Visibility miden un fantasma.
El ERR es, por tanto, la métrica previa y habilitante: sin reconocimiento correcto no hay visibilidad fiable.
Su lectura segmentada por bloque, por modelo y junto al resto de dimensiones convierte el dato en un diagnóstico accionable sobre la calidad de la representación de la entidad en la IA.
🔁 Consistencia de Citación – Citation Consistency, CC
Qué mide: la estabilidad de las fuentes citadas por el modelo para una misma entidad a lo largo del tiempo y entre diferentes prompts, modelos o idiomas.
Cómo medirlo: registrar dominios, URLs y fuentes citadas por respuesta; calcular solapamiento entre conjuntos de fuentes por ejemplo, índice de Jaccard, porcentaje de fuente principal repetida, número de fuentes distintas y variación temporal.
También puede medirse la entropía de fuentes: menor entropía, mayor consistencia.
Interpretación: una CC alta sugiere que el modelo asocia la entidad a fuentes estables y reconocibles.
Una CC baja indica fuentes volátiles, respuestas variables o poca consolidación de autoridad.
Es útil para detectar cambios de narrativa y dependencia excesiva de una única fuente.
🔁 Ejemplo práctico: Consistencia de Citación – Citation Consistency, CC
Contexto del caso
Seguimos con Planify, la marca ficticia de software de gestión de proyectos.
Ya sabemos que su Mention Ratio es del 28 %, su Citation Ratio del 8 %, su prominencia media de 2,43 sobre 5 y su ERR del 70 %.
Ahora queremos responder a una pregunta que ninguna de esas métricas resuelve: cuando la IA cita a Planify, ¿cita siempre las mismas fuentes? ¿O depende del prompt, del modelo o del momento?
La consistencia de citación mide la estabilidad de las fuentes que el modelo usa para una misma entidad a lo largo del tiempo y entre distintos prompts.
Una entidad con CC alta tiene una autoridad consolidada: la IA siempre recurre a las mismas referencias.
Una CC baja indica volatilidad, dependencia de fuentes cambiantes o falta de consolidación.
Para este ejemplo reutilizamos las 12 respuestas con citación detectadas en el ejemplo de Citation Rateo, y añadimos una segunda medición un mes después para evaluar estabilidad temporal.
Paso 1: Definir qué se registra en cada citación
Para cada respuesta con citación se anota:
Dominio citado p. ej., planify.com, g2.com, techcrunch.com
URL o página concreta si está disponible
Tipo de fuente: propia dominio de la entidad vs. tercera medio, directorio, review
Modelo y prompt que generó la citación
Fecha de la ejecución
Paso 2: Registrar las citaciones medición 1
En la primera medición, las 12 citaciones se distribuyen así:
| Fuente citada | Tipo | Nº de citaciones | % |
| planify.com | Propia | 4 | 33,3 % |
| g2.com | Tercera (reviews) | 3 | 25 % |
| techcrunch.com | Tercera (medio) | 2 | 16,7 % |
| capterra.com | Tercera (directorio) | 2 | 16,7 % |
| wikipedia.org | Tercera (enciclopedia) | 1 | 8,3 % |
| Total | 12 | 100 % |
Fuentes distintas: 5
Fuente principal: planify.com 33,3 %
Paso 3: Calcular métricas de consistencia
a) Índice de concentración de fuente principal:
CC principal = citaciones de la fuente más usada / total de citaciones = 4 / 12 = 33,3 %
b) Índice de Jaccard entre dos medicionessolapamiento de fuentes:
Si en la medición 2 las fuentes son {planify.com, g2.com, capterra.com, reddit.com, producthunt.com}, el conjunto de la medición 1 era {planify.com, g2.com, techcrunch.com, capterra.com, wikipedia.org}.
Intersección: {planify.com, g2.com, capterra.com} → 3 fuentes
Unión: 7 fuentes
Jaccard = 3 / 7 = 0,43 → 43 %
c) Entropía de fuentesdiversidad: a mayor entropía, menor consistencia. Con 5 fuentes y distribución 33/25/17/17/8, la entropía normalizada es aproximadamente 0,92alta diversidad → baja concentración.
d) Estabilidad temporal:comparar la fuente principal en medición 1 y medición 2.
Paso 4: Segmentar por modelo y por intención
| Modelo | Citaciones | Fuentes distintas | Fuente principal | CC principal |
| ChatGPT | 5 | 3 | planify.com (40 %) | 40 % |
| Gemini | 4 | 3 | g2.com (50 %) | 50 % |
| Claude | 3 | 3 | planify.com (33 %) | 33 % |
| Intención | Citaciones | Fuentes distintas | CC principal |
| Informacional | 6 | 2 | planify.com (50 %) |
| Comparativa | 4 | 3 | g2.com (50 %) |
| Transaccional | 1 | 1 | capterra.com (100 %) |
| Reputacional | 1 | 1 | g2.com (100 %) |
Paso 5: Segunda medición (un mes después)
|
Fuente citada |
Medición 1 | Medición 2 | Variación |
| planify.com | 4 | 3 | −1 |
| g2.com | 3 | 4 | +1 |
| techcrunch.com | 2 | 0 | −2 |
| capterra.com | 2 | 3 | +1 |
| wikipedia.org | 1 | 1 | 0 |
| reddit.com | 0 | 1 | +1 |
| producthunt.com | 0 | 1 | +1 |
| Total | 12 | 13 | +1 |
Fuentes distintas: 5 → 6
Jaccard entre mediciones: 43 %
Fuente principal: planify.com M1 → g2.com M2
Paso 6: Interpretar el resultado
CC principal del 33,3 % M1: la fuente más citada solo concentra un tercio de las citaciones.
No hay una fuente dominante clara: la IA recurre a cinco fuentes distintas. La consistencia es media-baja.
Jaccard del 43 % entre mediciones: menos de la mitad de las fuentes se mantienen de un mes a otro. techcrunch.com desaparece, reddit.com y producthunt.com aparecen. La autoridad no está consolidada.
Cambio de fuente principal plani→ g2.com: la IA está desplazando su confianza desde la fuente propia hacia un directorio de reviews.
Esto puede ser positivo más prueba social o negativo pérdida de control sobre la narrativa.
Mejor consistencia informacional 50 % en planify.co: cuando el usuario pregunta «qué es», el modelo recurre de forma estable a la documentación propia.
Hay autoridad reconocida en ese contexto.
Consistencia débil en comparativa: la fuente principal es g2.com, pero con diversidad alta.
La IA no tiene una referencia única para comparar a Planify.
Paso 7: Convertir el dato en acción
CC baja + Citation Ratio bajo → la entidad no solo es poco citada, sino que cuando lo es, las fuentes son volátiles.
Acción: consolidar una fuente canónica (página de referencia, documentación, ficha en directorios clave) y trabajarla de forma sostenida.
Cambio de fuente principal hacia g2.com → la IA confía más en reviews de terceros que en la fuente propia.
Acción: gestionar activamente la presencia en G2, Capterra y similares; incentivar reviews; responder a reseñas.
Pérdida de techcrunch.com → la cobertura en medios no se sostiene. Acción: trabajar earned media recurrente, no solo picos puntuales.
Aparición de reddit.com y producthunt.com → la IA empieza a incorporar fuentes comunitarias.
Acción: monitorizar y participar en esas conversaciones.
Acciones derivadas del ejemplo:
Crear y mantener una página de referencia canónica que los modelos citen de forma estable.
Reforzar la presencia en g2.com y capterra.com con reviews actualizadas.
Recuperar presencia en medios tecnológicos con contenido recurrente.
Repetir la medición mensualmente y fijar objetivo: subir el CC principal del 33 % al 50 % y el Jaccard entre mediciones del 43 % al 70 % en seis meses.
✅ Lectura final del ejemplo
La CC principal del 33,3 % y el Jaccard del 43 % revelan algo que el Citation Ratio no mostraba: Planify no solo es poco citada, sino que sus fuentes son inestables.
La IA cambia de referencia de un mes a otro, y la fuente principal se ha desplazado de la web propia a un directorio de reviews.
Esa volatilidad indica que la autoridad de la entidad no está consolidada: no hay una referencia canónica que el modelo use de forma consistente.
La consistencia de citación es, por tanto, la métrica que distingue entre ser citado de forma anecdótica y ser una fuente de confianza estable en AI Visibility.
Su lectura segmentada por modelo, por intención y en el tiempo convierte el dato en un diagnóstico accionable sobre la solidez de la autoridad de la entidad.
🎭 Sentimiento y Representación – Sentiment / Framing
Qué mide: el tono, contexto y atributos con los que se menciona a la entidad, así como la exactitud de la información y la tasa de alucinación.
Cómo medirlo: clasificar el sentimiento por mención —positivo, neutro, negativo—; analizar el framing —líder, alternativa, opción económica, riesgo, obsoleto, innovador—; verificar afirmaciones contra fuentes fiables; calcular:
Hallucination Rateo = afirmaciones falsas o no verificables / afirmaciones verificables
Interpretación: una entidad puede tener alta visibilidad y, aun así, estar mal representada.
El sentimiento negativo o la información inexacta pueden dañar la percepción y la confianza.
Esta métrica debe leerse junto con prominencia y citación: no solo importa cuánto aparece, sino cómo y con qué precisión.
🎭 Ejemplo práctico: Sentimiento y Representación – Sentiment / Framing
Contexto del caso
Llegamos a la última métrica del marco, y con Planify, la marca ficticia de software de gestión de proyectos, ya tenemos un diagnóstico bastante completo:
Mention Ratio del 28 %, Citation Ratio del 8 %, prominencia media de 2,43 sobre 5, ERR del 70 % y CC principal del 33,3 % con un Jaccard del 43 %
Sabemos que aparece poco, que no es fuente estable y que a veces se confunde con homónimos.
Pero queda la pregunta más importante para la reputación: cuando la IA habla de Planify, ¿cómo lo hace? ¿Con qué tono, en qué marco framing y con qué exactitud?
Esta métrica mide dos cosas a la vez:
Sentimiento: el tono de la mención (positivo, neutro, negativo).
Representación (framing): el rol o atributo con el que se asocia a la entidad (líder, alternativa, opción económica, obsoleta, arriesgada, innovadora…), junto con la exactitud de lo que se dice y la tasa de alucinación.
Para este ejemplo reutilizamos las 42 respuestas con mención del prompt set de visibilidad, ejecutadas en 3 modelos.
Paso 1: Definir la escala de sentimiento y las categorías de framing
Escala de sentimiento por mención:
| Categoría | Descripción | Valor |
| Positivo | Se destaca un atributo favorable, se recomienda o se elogia | +1 |
| Neutro | Se describe sin juicio de valor | 0 |
| Negativo | Se critica, se advierte o se asocia a un problema | −1 |
Categorías de framing una o varias por mención:
Líder / referente
Alternativa / opción válida
Opción económica / gratuita
Herramienta de nicho
Obsoleta / en declive
Arriesgada / con limitaciones
Innovadora / emergente
Exactitud: cada afirmación verificable se contrasta con la ficha de entidad. Se calcula la tasa de alucinación:
Hallucination Rateo = afirmaciones falsas o no verificables / afirmaciones verificables
Paso 2: Clasificar el sentimiento de las 42 menciones
| Sentimiento | Nº de menciones | % sobre menciones |
| Positivo | 11 | 26,2 % |
| Neutro | 24 | 57,1 % |
| Negativo | 7 | 16,7 % |
| Total | 42 | 100 % |
Sentiment Score ponderado:
(11×(+1) + 24×0 + 7×(−1)) / 42 = (11 − 7) / 42 = 4 / 42 ≈ +0,10
Sentiment Score = +0,10 en una escala de −1 a +1 → ligeramente positivo, casi neutro.
La IA habla de Planify sin entusiasmo ni hostilidad: la describe, pero no la ensalza.
Paso 3: Analizar el framing dominante
| Framing | Nº de menciones | % |
| Alternativa / opción válida | 15 | 35,7 % |
| Herramienta de nicho | 9 | 21,4 % |
| Opción económica / gratuita | 6 | 14,3 % |
| Líder / referente | 4 | 9,5 % |
| Innovadora / emergente | 3 | 7,1 % |
| Arriesgada / con limitaciones | 3 | 7,1 % |
| Obsoleta / en declive | 2 | 4,8 % |
| Total | 42 | 100 % |
Framing dominante: «alternativa / opción válida» 35,7 % y «herramienta de nicho» 21,4 %
Planify no se presenta como líder solo 9,5 %, sino como una opción secundaria o especializada.
Eso conecta directamente con su baja prominencia posicional 2,43/5
Paso 4: Medir la exactitud y la tasa de alucinación
Se extraen las afirmaciones verificables de las 42 menciones y se contrastan:
| Resultado | Nº de afirmaciones | % |
| Correctas | 58 | 72,5 % |
| Parcialmente correctas | 12 | 15 % |
| Falsas o no verificables | 10 | 12,5 % |
| Total | 80 | 100 % |
Cálculo:
Hallucination Ratio = 10 / 80 = 0,125 → 12,5 %
Ejemplos de alucinaciones detectadas:
| Afirmación generada por la IA | Realidad |
| «Planify se fundó en 2015 en Madrid» | Se fundó en 2019 en Barcelona |
| «Planify es una plataforma de planificación financiera» | Es software de gestión de proyectos (confusión con Planful) |
| «Planify no tiene plan gratuito» | Sí lo tiene |
| «Planify fue adquirida por Asana en 2022» | Falso, no ha sido adquirida |
Paso 5: Segmentar por intención y por modelo
| Intención | Menciones | Sentiment Score | Framing dominante | Hallucination Ratio |
| Informacional | 18 | +0,11 | Alternativa válida | 8 % |
| Comparativa | 15 | +0,07 | Alternativa / nicho | 14 % |
| Transaccional | 6 | +0,17 | Opción económica | 12 % |
| Reputacional | 3 | −0,33 | Arriesgada / con limitaciones | 25 % |
| Total | 42 | +0,10 | Alternativa válida | 12,5 % |
| Modelo | Menciones | Sentiment Score | Hallucination Ratio |
| ChatGPT | 17 | +0,18 | 9 % |
| Gemini | 14 | +0,07 | 13 % |
| Claude | 11 | +0,00 | 18 % |
Paso 6: Interpretar el resultado
Sentiment Score +0,10: la IA es casi neutra con Planify.
No hay entusiasmo ni rechazo, pero tampoco diferenciación.
La marca se describe correctamente, pero sin atributos que la hagan deseable.
Framing dominante «alternativa / nicho» 57,1 % combinado: la IA no ve a Planify como líder, sino como una opción secundaria o especializada.
Esto es coherente con su baja prominencia 2,43/5 y su bajo Citation Rateo 8 %.
La representación refuerza la invisibilidad.
Sentimiento negativo en reputacional −0,33: cuando se pregunta por fiabilidad, el tono cae.
Es la señal más preocupante: la marca no se asocia a confianza.
Hallucination Ratio del 12,5 %: 1 de cada 8 afirmaciones verificables es falsa.
Los errores se concentran en atributos básicos (fundación, sede, modelo de negocio) y en la confusión con Planful.
Esto conecta con el ERR del 70 %: la representación inexacta es síntoma de un reconocimiento débil.
Brecha entre modelos ChatGPT +0,18 / 9 % vs Claude 0,00 / 18 %: Claude no solo menciona menos y peor a Planify, sino que la representa con más errores y menos positividad.
La visibilidad no es homogénea.
Paso 7: Convertir el dato en acción
Sentiment neutro + framing de «alternativa» → la marca no tiene una narrativa diferenciada.
Acción: construir y comunicar atributos diferenciales claros para quién es Planify, qué problema resuelve mejor que nadie que los modelos puedan reproducir.
Sentimiento negativo en reputacional → falta prueba social y señales de confianza.
Acción: trabajar reviews, casos de éxito y menciones en fuentes fiables.
Hallucination Ratio del 12,5 % → errores en atributos básicos y confusión con homónimos.
Acción: datos estructurados schema.org, página de referencia canónica, contenido de desambiguación y actualización de fuentes.
Framing «opción económica» → puede ser una fortaleza si se trabaja estratégicamente, o un ancla si no se matiza.
Acción: decidir si ese es el posicionamiento deseado y reforzarlo con contenido.
Acciones derivadas del ejemplo:
Crear una narrativa de posicionamiento clara y repetible que los modelos puedan adoptar.
Publicar casos de éxito y reviews verificables para mejorar el sentimiento reputacional.
Corregir los atributos erróneos en las fuentes que la IA consulta web propia, Wikidata, directorios.
Repetir la medición mensualmente y fijar objetivo: subir el Sentiment Score de +0,10 a +0,35, reducir el framing de «nicho» por debajo del 20 % y bajar el Hallucination Ratio del 12,5 % al 5 % en seis meses.
✅ Lectura final del ejemplo
El Sentiment Score de +0,10, el framing dominante de «alternativa / nicho» y el Hallucination Ratio del 12,5 % revelan algo que ninguna métrica anterior mostraba con tanta claridad: la IA no solo menciona poco a Planify, sino que la representa como una opción secundaria y con errores.
La marca aparece, pero sin liderazgo, sin entusiasmo y con una exactitud mejorable.
Esa combinación visibilidad baja, prominencia baja, autoridad baja y representación floja dibuja un diagnóstico coherente.
Planify es una entidad reconocida a medias, citada de forma inestable y representada como alternativa, no como referente.
El sentimiento y la representación cierran el marco de AI Visibility porque responden a la pregunta que más importa: no solo si la IA habla de la entidad, sino si habla bien, con exactitud y en el marco que la entidad desea ocupar.
Su lectura segmentada por intención, por modelo y junto al resto de métricas convierte el dato en un diagnóstico accionable sobre reputación y posicionamiento en la era de las respuestas generativas.
🧭 Cierre del marco completo: Planify en una mirada
| Métrica | Resultado | Diagnóstico |
| 📣 Mention Rateo | 28 % | Aparece, sobre todo en informacional |
| 🔗 Citation Rateo | 8 % | Rara vez es fuente |
| 📍 Prominencia | 2,43/5 | Aparece, pero no destaca |
| 🧠 ERR | 70 % | Reconocimiento parcial, confusión con homónimos |
| 🔁 CC | 33,3 % / Jaccard 43 % | Autoridad no consolidada, fuentes volátiles |
| 🎭 Sentiment / Framing | +0,10 / «alternativa» / 12,5 % alucinación | Representación neutra, secundaria y con errores |
Conclusión del caso: Planify no tiene un problema de existencia en la IA, sino de consolidación.
Se la conoce, pero no se la destaca, no se la cita de forma estable y no se la representa como líder.
Las seis métricas, leídas en conjunto, convierten esa intuición en un plan de acción medible y priorizable.
🧭 Cómo operativizar estas métricas
Definir la entidad y sus alias marca, producto, persona u organización y los homónimos que puedan generar confusión.
Crear un prompt set estable de alto valor por intención: informacional, comparativa, transaccional y reputacional.
Medir en varios modelos, idiomas y fechas para capturar variabilidad.
Separar siempre mención, citación, posición, reconocimiento, consistencia y representación.
Construir un dashboard de AI Visibility con línea base, evolución temporal y alertas por caídas de ERR, CC o aumento de alucinaciones.
La lectura conjunta de estas seis dimensiones permite saber no solo si la IA habla de la entidad, sino si la reconoce bien, la descubre en contextos relevantes, la cita con autoridad, la posiciona con prominencia, mantiene fuentes estables y la representa con exactitud.