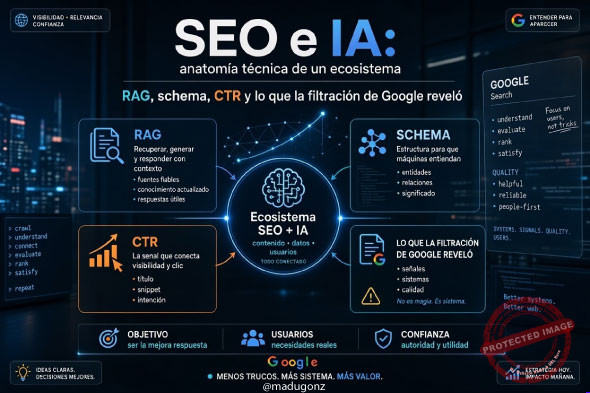
«SEO e IA: anatomía técnica de un ecosistema – RAG, schema, CTR y lo que la filtración de Google reveló»
«Un análisis basado en evidencia empírica: por qué el schema no es un atajo causal, por qué el chunking no está en tu mano y por qué el SEO técnico se ha convertido en la infraestructura de la citabilidad.»
Hay un momento en toda disciplina incipiente en el que el ruido supera a la señal.
Ocurrió con el SEO en sus primeros años cuando cada foro tenía su teoría sobre el «factor secreto» de Google y está ocurriendo ahora con la intersección entre SEO e inteligencia artificial.
Cada semana aparece un nuevo «método definitivo» para que ChatGPT te cite, una lista de «los 10 trucos de schema que la IA adora» o un hilo viral que asegura haber descubierto el patrón que separa a las marcas visibles de las invisibles.
La mayoría de esas afirmaciones tienen algo en común: confunden correlación con causalidad, generalizan a partir de anécdotas y no resisten el escrutinio de un estudio controlado.
Este artículo nace de la incomodidad con ese ruido.
No pretende ofrecer otra receta, sino lo contrario: separar lo que sabemos de lo que creemos saber en el territorio SEO + IA, usando la evidencia empírica disponible estudios con muestras grandes, filtraciones de documentación interna, mediciones de CTR a escala como filtro.
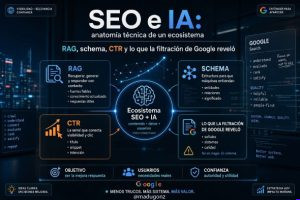
La tesis de partida es que SEO e IA no son dos disciplinas en guerra ni dos modas superpuestas, sino dos capas de un mismo ecosistema de recuperación de información: comparten infraestructura, comparten señales de autoridad y comparten un objetivo operativo que se ha desplazado del clic a la extraibilidad.
Lo que vas a encontrar aquí
El lector que llegue buscando «el truco» se irá decepcionado.
El que llegue buscando entender cómo funcionan realmente los mecanismos encontrará un recorrido estructurado en cinco bloques técnicos, cada uno anclado en fuentes verificables:
Primero, cómo «lee» la IA.
Desmontamos la idea de que los LLMs navegan páginas web como un usuario y explicamos el pipeline real de Retrieval-Augmented Generation (RAG): fragmentación, vectorización y recuperación.
La conclusión incómoda es que el chunking esa obsesión reciente por «optimizar párrafos para IA» no es una palanca que el SEO controle: es una decisión de ingeniería del proveedor del modelo.
Lo que sí está en tu mano es producir unidades de significado recuperables, y ahí la estructura semántica importa más que cualquier gimmick.
Segundo, el mito del schema como atajo.
Presentamos el estudio de Ahrefs (2025–2026) sobre 1.885 páginas tratadas frente a 4.000 de control, y su resultado es tan contundente como contraintuitivo: añadir JSON-LD no aumenta las citas de IA de forma estadísticamente significativa en ChatGPT, AI Mode ni AI Overviews.
Explicamos por qué el schema sigue siendo útil como marcador de madurez técnica, pero no como multiplicador causal de visibilidad.
Es la diferencia entre «las páginas citadas usan schema» y «usar schema hace que te citen».
Tercero, el coste real de la visibilidad.
Analizamos los datos convergentes de Ahrefs, Pew Research y Seer Interactive sobre la caída del CTR cuando aparece un AI Overview: cifras que van del 34,5% al 68% según la medición y la plataforma.
Y presentamos la paradoja que define esta era: ser citado por la IA otorga visibilidad de marca pero no transfiere tráfico proporcional solo el 1% de los usuarios hace clic en los enlaces citados dentro del propio resumen de IA.
La posición #1 sigue existiendo, pero su ventaja competitiva se ha desinflado estructuralmente.
Cuarto, lo que la filtración de Google nos enseñó.
En mayo de 2024 se filtraron más de 14.000 atributos internos de la Content Warehouse API.
Los usamos como fuente primaria para anclar dos factores que Google negaba públicamente: la existencia de una autoridad de sitio medible (siteAuthority) y el papel del comportamiento de clic (NavBoost, con sus componentes goodClicks, badClicks y lastLongestClicks, confirmados bajo juramento por Pandu Nayak en el caso del DOJ).
Conectamos esos hallazgos con la forma en que los LLMs podrían estar heredando señales de autoridad del ecosistema de Google.
Quinto, la base técnica.
Cerramos con los umbrales concretos que determinan si tu contenido es recuperable: TTFB < 800 ms, LCP < 2,5 s, contenido crítico < 3 s, renderizado del lado del servidor (SSR/SSG) para evitar cáscaras de HTML vacías, y un enlazado interno que construye un grafo de conocimiento no solo distribuye autoridad, sino que define relaciones semánticas que los crawlers de IA leen como adyacencia conceptual.
Por qué esto es necesario ahora
La razón por la que este artículo es urgente no es académica.
Es operativa. Los equipos de SEO están tomando decisiones de inversión basadas en narrativas que la evidencia no respalda: rediseñando arquitecturas para «optimizar chunks» que el pipeline del modelo fragmentará a su antojo, invirtiendo en schema esperando un retorno causal que los estudios controlados no confirman, o ignorando los fundamentos técnicos (velocidad, renderizado, enlazado) que sí determinan si el contenido llega siquiera a ser considerado.
El coste de esa confusión no es abstracto: es presupuesto mal asignado y oportunidades perdidas.
La conclusión que emerge de todo el recorrido es, a la vez, modesta y radical: el SEO técnico no desaparece en la era de la IA; se convierte en su infraestructura fundacional.
Lo que siempre importó entregar el contenido real en el HTML inicial, con latencia baja, con un grafo de enlazado que defina relaciones semánticas no solo sigue importando: ahora es la condición previa de la citabilidad.
Todo lo demás, en ausencia de esa base, es decoración.
Lo que sigue no es un manifiesto ni una predicción.
Es un intento de documentar con rigor lo que la evidencia permite afirmar, lo que permite refutar y lo que todavía no sabemos.
Si al terminar el lector puede distinguir con claridad entre las tres categorías, el artículo habrá cumplido su propósito.
1. Introducción: el ecosistema bilingüe (SEO + IA)
La tesis de partida es que SEO e IA no son dos disciplinas separadas que compiten por el mismo territorio, sino dos capas de un mismo ecosistema de recuperación de información.
El SEO clásico optimiza para un algoritmo que indexa, clasifica y sirve resultados en una SERP.
Los sistemas de IA generativa optimizan para un pipeline que recupera fragmentos, los incrusta como vectores y los ens ensambla en una respuesta sintetizada.
Comparten infraestructura (el HTML, la arquitectura del sitio, las señales de autoridad), pero los criterios de «éxito» divergen: en SEO, el éxito es el clic; en IA, el éxito es la extraibilidad y la citabilidad del fragmento.
El problema de gran parte del contenido que circula sobre «SEO para IA» es que confunde correlación con causalidad y convierte observaciones superficiales (las páginas citadas tienen más schema, luego el schema hace que te citen) en recetas universales.
Este artículo parte de la evidencia empírica disponible estudios controlados, filtraciones de documentación interna y mediciones de CTR a gran escala para separar lo que sabemos de lo que creemos saber.
2. Cómo «lee» la IA: RAG, chunking y el mito del control granular
Los Large Language Models (LLMs) no «leen» páginas web de la forma en que lo hace un usuario.
El mecanismo dominante en los sistemas de búsqueda con IA es Retrieval-Augmented Generation (RAG).
El pipeline típico de RAG opera en varias fases: el documento se fragmenta en unidades pequeñas (chunks), cada chunk se vectoriza (se convierte en una representación numérica que captura su significado), y esos vectores se almacenan en una base de datos.
Ante una consulta, el sistema recupera los chunks más relevantes y los pasa al modelo generativo como contexto para producir la respuesta.
Aquí está el punto crítico que desmonta muchas narrativas SEO: el chunking es una decisión de ingeniería del proveedor del modelo, no una palanca que el SEO pueda optimizar directamente.
Diferentes LLMs utilizan distintos límites de tokens y estrategias de fragmentación, optimizadas por precisión, coste y eficiencia.
El hecho de que tu contenido tenga párrafos de 50 o 150 palabras es irrelevante para cómo Google o ChatGPT lo fragmentan internamente.
El sistema, no tu formato, decide qué constituye un chunk y cómo se corta.
Lo que sí está en tu mano es la atomicidad del contenido: crear secciones autocontenidas que respondan a una consulta de forma clara y puedan sostenerse por sí mismas, sin depender del párrafo anterior o posterior para tener sentido.
Eso funciona tanto para humanos como para LLMs, sin necesidad de gimmicks de «optimización de chunks».
La estructura semántica (encabezados claros, entidades consistentes, secciones que agotan un subtema) importa, pero no porque «formatee chunks», sino porque produce unidades de significado recuperables cuando el pipeline de RAG las vectoriza.
3. El mito del Schema como atajo: correlación vs. causalidad
La observación de partida es tentadora: las páginas citadas por IA tienen casi tres veces más probabilidades de usar JSON-LD que las no citadas.
Ahrefs lo verificó analizando 6 millones de URLs. La conclusión apresurada «añade schema y te citarán más» es exactamente el tipo de error que un artículo técnico debe desmontar.
Ahrefs diseñó un segundo estudio para aislar la causalidad: rastreó 1.885 páginas que añadieron JSON-LD entre agosto de 2025 y marzo de 2026, las emparejó con 4.000 páginas de control comparables, y midió el cambio en citas en Google AI Overviews, AI Mode y ChatGPT.
El resultado fue contundente: añadir schema no produjo ningún aumento significativo de citas en ninguna plataforma.
En AI Overviews, las páginas tratadas experimentaron una caída del 4,6% relativa a los controles (estadísticamente significativa, pero con un tamaño absoluto pequeño: unas 12 citas diarias menos por página en una muestra donde la mayoría obtenía cientos).
En AI Mode (+2,4%) y ChatGPT (+2,2%), el efecto fue estadísticamente indistinguible de cero.
La explicación es la que cualquier investigador debería esperar: el schema markup tiende a vivir en sitios mejor mantenidos, más sofisticados técnicamente, que también publican mejor contenido, construyen más autoridad y ganan más enlaces.
El schema puede estar cabalgando la ola de todas las demás señales, no generándolas.
Esto no significa que el schema sea inútil; significa que no es un atajo causal.
Es un marcador de madurez técnica, no un multiplicador de citas por sí mismo.
4. El coste real de la visibilidad: los datos de CTR y la paradoja de la cita
La narrativa de que «la IA quita clics» tiene respaldo empírico robusto, pero las cifras varían según el objeto medido.
Un artículo técnico debe presentar el rango, no un número único descontextualizado.
Los datos convergentes de los principales estudios:
Ahrefs (300.000 keywords, diciembre 2025): cuando aparece un AI Overview, el CTR del resultado orgánico en posición #1 cae un 58%
En una medición anterior (marzo 2024 vs. marzo 2025), la caída reportada fue del 34,5%
Pew Research Center (julio 2025): solo el 8% de los usuarios hace clic en un resultado tradicional cuando hay un resumen de IA, frente al 15% cuando no lo hay.
Una caída del 47% en la probabilidad de clic.
Más revelador aún: solo el 1% de los usuarios hace clic en los enlaces citados dentro del propio AI Overview.
Seer Interactive (3.119 queries, 42 organizaciones, 25,1 millones de impresiones): el CTR orgánico cae un 61% cuando aparece un AI Overview de 1,76% a 0,61%
El CTR de paid search cae aún más: 68%.
La paradoja es esta: ser citado por la IA otorga visibilidad de marca, pero no transfiere tráfico de forma proporcional.
Ahrefs encontró que el 76,1% de las URLs citadas dentro de AI Overviews también aparecen en el top 10 orgánico.
Es decir, la IA está extrayendo de los mismos contendientes que antes competían por el clic, pero ahora el usuario obtiene la respuesta sin necesidad de hacer ese clic.
La posición #1 sigue existiendo, pero su ventaja competitiva en CTR se ha desinflado estructuralmente.
5. Lo que la filtración del Content Warehouse API reveló sobre autoridad y clics
En mayo de 2024 se filtraron más de 14.000 atributos internos de la documentación de la Content Warehouse API de Google.
Para un artículo técnico, esta filtración es una fuente primaria que permite anclar los factores de ranking en evidencia documental, no en especulación.
Dos hallazgos son directamente relevantes para entender cómo los LLMs podrían estar heredando señales de autoridad:
1. La autoridad de sitio es real y medible.
Los documentos exponen un atributo siteAuthority dentro del módulo CompressedQualitySignals, descrito como una puntuación de calidad a nivel de dominio que Google usa para ponderar la confiabilidad general de un sitio, distinta del link equity a nivel de página.
Si los sistemas de IA se entrenan o se guían por señales de autoridad agregada (de dominio, de entidad), es plausible que estén reproduciendo consciente o inconscientemente una lógica de «sitio confiable» que Google ya venía midiendo.
2. El comportamiento de clic (NavBoost) es un factor de ranking confirmado.
La filtración nombra el sistema NavBoost y sus componentes: goodClicks (clics que terminan en satisfacción, sin retorno rápido a la SERP), badClicks (pogo-sticking) y lastLongestClicks (el clic sostenido más largo para una query).
Pandu Nayak, de Google, confirmó NavBoost bajo juramento en el contexto del caso antimonopolio del DOJ.
La documentación filtrada muestra que Google clasifica los clics y los usa como señal.
Para los LLMs, la conexión no es directa, pero el principio subyace: si un contenido genera interacción sostenida y satisfacción en el ecosistema de Google, es más probable que también sea el tipo de contenido que los sistemas de IA seleccionen como fuente de autoridad.
La filtración no demuestra que los LLMs «lean» NavBoost.
Demuestra que las señales que Google siempre midió autoridad de dominio, comportamiento de clic eran reales, no mitos de foro.
Y si los LLMs se apoyan en índices y señales derivadas del ecosistema de Google (como AI Overviews), es razonable inferir que esas mismas señales influyen en la selección de fuentes citables.
6. La base técnica: velocidad, renderizado y arquitectura de la información
Si la IA recupera fragmentos de un índice, el contenido debe estar disponible para ser recuperado antes de que cualquier estrategia semántica importe.
Aquí es donde el SEO técnico clásico se convierte en la infraestructura de la citabilidad.
Los umbrales concretos:
TTFB (Time to First Byte): el objetivo operativo para páginas que se quieren citables de forma consistente es inferior a 800 ms, con umbrales más agresivos de 200–500 ms en guías técnicas especializadas.
Un TTFB alto significa que los bots de IA pasan más tiempo de reloj esperando que el contenido empiece a llegar, lo que aumenta la probabilidad de timeout o de abandono del crawler.
LCP (Largest Contentful Paint): el umbral crítico es < 2,5 segundos.
En el contexto de IA, el criterio clave es «< 3 segundos hasta el contenido crítico«: no la velocidad a la que el usuario ve una página visualmente completa, sino la velocidad a la que el HTML primario y el contenido above-the-fold llegan al crawler.
Renderizado: si el contenido crítico depende de JavaScript del lado del cliente (CSR), el crawler encuentra una cáscara de HTML vacía y debe esperar a una segunda pasada por el Web Rendering Service.
Cualquier timeout o error en ese proceso puede llevar a la exclusión inmediata de la cola de renderizado.
La recomendación técnica es SSR (Server-Side Rendering) o SSG (Static Site Generation) para el contenido que se quiere citable: el HTML inicial debe contener el contenido real, no una promesa de contenido.
El enlazado interno como grafo de conocimiento: en el SEO clásico, los enlaces internos transferían autoridad y facilitaban el rastreo.
En el contexto de la IA, los crawlers leen los enlaces internos como evidencia de relaciones semánticas, no solo como flujo de PageRank.
Cada enlace se convierte en una arista semántica que conecta nodos (páginas) y permite al sistema inferir adyacencia conceptual: qué temas se relacionan con qué otros, qué páginas son hubs autoritativos y cuáles son satélites.
Los enlaces deben estar dentro del cuerpo pre-renderizado, con anchors descriptivos, porque la navegación que solo vive en el pie de página o depende de JavaScript no es leída por los bots que omiten la ejecución de JS.
Un grafo de enlazado interno bien diseñado no solo distribuye autoridad: construye el mapa de conocimiento que la IA necesita para entender de qué es autoridad tu sitio.
7. Conclusión: el SEO técnico como infraestructura de la extraibilidad
La evidencia converge en una conclusión que reordena las prioridades: el SEO técnico no desaparece en la era de la IA; se convierte en la capa fundacional de la citabilidad.
El schema no es un atajo causal (los datos de Ahrefs lo demuestran), el chunking no es una palanca de control granular (es una decisión del pipeline del modelo), y las cifras de CTR confirman que la visibilidad en IA no se traduce automáticamente en tráfico.
Lo que sí queda en el territorio de la acción técnica es lo que siempre importó, ahora con mayor urgencia: entregar el contenido en el HTML inicial, con TTFB bajo, LCP contenido y un grafo de enlazado interno que defina relaciones semánticas.
Eso es lo que hace que un fragmento sea recuperable, vectorizable y, en última instancia, citable.
El resto las narrativas de «optimización de chunks» y los atajos de schema son ruido que la evidencia empírica permite filtrar.