Instrumento para hacer auditable la medición de visibilidad en sistemas de IA generativa
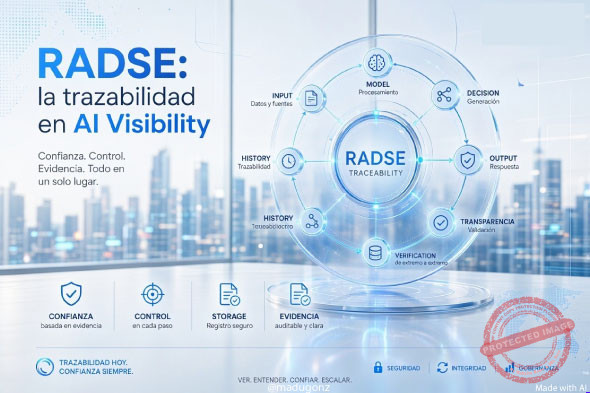
RADSE es un marco de trazabilidad y calibración para la medición de visibilidad en sistemas generativos.
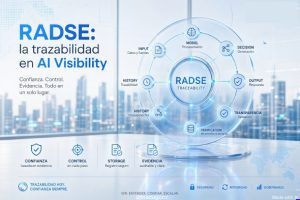
Se compone de cinco capas encadenadas Recuperación, Dinámica, Autoridad, Sesiones y Equidad de entidad y su función no es medir visibilidad, sino hacer auditable la medición de visibilidad: garantizar que toda afirmación sobre lo que un motor generativo dice, cita o recomienda pueda reconstruirse eslabón por eslabón, con denominador declarado, verificador nombrado y criterio de falsación explícito.
El AVM mide la visibilidad; RADSE la hace trazable. Cinco capas, cinco letras: R de recuperación, D de dinámica, A de autoridad, S de sesiones, E de equidad de entidad. Sin una capa, la medición no es auditable.
RADSE no sustituye al AI Visibility Model AVM™
Lo complementa en una dimensión distinta: el AVM define qué se mide presencia, comprensión, recomendación; RADSE define cómo se traza y se verifica esa medición a lo largo de la cadena que va desde el índice hasta la recomendación, a través del tiempo, de la autoridad y de la conversación.
Dicho en una frase: el AVM mide la visibilidad; RADSE la hace trazable.
RADSE nace de una constatación empírica que el propio AVM dejó en caja negra: la mayoría de las herramientas y marcos de medición de visibilidad generativa miden la primera capa del proceso la aparición y presentan el resultado como si midiera la última,la recomendación.
Esa brecha produce afirmaciones que pueden ser ciertas y, sin embargo, no ser defendibles.
Una tasa de citación sin denominador, una “retención” medida solo en el primer turno, un “grafo de autoridad” construido sobre correlaciones sin contrafactuales, un “sesgo” que en realidad es una brecha de infraestructura de entidades.
RADSE se formula como respuesta a esa brecha.
No parte de una teoría nueva, sino de la evidencia acumulada en cinco frentes que el AVM identificó como zonas de penumbra.
La distinción entre recuperable y visible, la asimetría entre memoria paramétrica y recuperación aumentada, la diferencia entre optimización y explicación de la selección, la caída de visibilidad multi-turno, y la calibración por entidad.
Cada uno de esos frentes se convierte en una capa, y las cinco capas se encadenan en el orden en que la evidencia exige: primero la traza de fuente, luego su vigencia, luego la explicación de su selección, luego su comportamiento ecológico, y finalmente su calibración por tipo de entidad.
El nombre no es una metáfora: es un sistema de direccionamiento.
Cada letra es un eje, cada eje es una capa, y cada capa puede profundizarse sin romper el acrónimo.
Cuando se trabaja en recuperación, se dice “entramos en la capa R”; cuando se mide decaimiento, “medimos D-decay”; cuando se valida un contrafactual de autoridad, “validamos A-contrafactual”. RADSE no es solo una etiqueta: es un mapa que se puede recorrer letra a letra.
RADSE aporta cuatro cosas que el AVM, por sí solo, no puede dar:
1. Trazabilidad causal
Convierte una métrica de visibilidad en una cadena de custodia verificable: qué se recuperó, qué se citó, con qué fidelidad, durante cuánto tiempo, por qué se seleccionó, en qué turno sobrevivió y para qué tipo de entidad.
Sin esa cadena, un score es una fotografía; con RADSE, es un registro auditable.
2. Gobernanza operativa
Permite declarar qué eslabón está roto cuando una afirmación no es defendible.
Un dashboard puede decir “visibilidad 0,72”; RADSE debe poder decir qué capa sostiene ese 0,72 y cuál falla.
Eso es lo que separa un instrumento de un adorno.
3. Falsabilidad
Cada capa incorpora un test de falsación explícito.
La capa R se falsa con una ablación de fuente; la capa D, con una comparación entre modelo de decaimiento y línea base ingenua a 90 días; la capa A, con una manipulación de señal que debería cambiar la probabilidad de selección; la capa S, con un contraste entre condición de conversación libre y guiada; la capa E, con una comparación entre calibración por entidad y métrica agregada.
Sin test, una capa no entra en RADSE.
4. Escalabilidad regular
Las cinco capas comparten estructura idéntica: definición, tres preguntas, objeto trazado, insumo, producto, métricas con denominador, test de falsación y dependencia rota.
Esa regularidad permite que el marco crezca sin perder comparabilidad entre capas y sin que cada nuevo desarrollo sea un dialecto distinto.
El proyecto principal tiene tres niveles, y RADSE opera en el segundo:
| Nivel | Componente | Función |
| Modelo | AVM™ | Define qué se mide: presencia, comprensión, recomendación |
| Marco | RADSE | Define cómo se traza y se verifica esa medición, capa por capa |
| Protocolo | Documento Cero RADSE | Convierte cada capa en ficha operativa con fórmulas, denominadores y tests |
El encaje es secuencial, no paralelo.
El AVM fija las dimensiones; RADSE las descompone en eslabones verificables; el Documento Cero las convierte en instrumento.
Sin el AVM, RADSE no tendría qué trazar; sin RADSE, el AVM no tendría cómo defenderse; sin el Documento Cero, RADSE sería un mapa sin brújula.
La retroalimentación es bidireccional.
RADSE recibe del AVM las dimensiones que debe custodiar y devuelve al AVM cinco capacidades que el modelo no tenía: trazabilidad causal (R), dinámica gobernable (D), explicación de selección (A), validez ecológica (S) y calibración equitativa (E).
Con esas cinco capacidades, el AVM deja de ser un marco descriptivo y pasa a ser un modelo predictivo y falsable.
RADSE: Marco de Trazabilidad y Calibración de Visibilidad Generativa
Resumen ejecutivo
RADSE es un marco de trazabilidad y calibración para la medición de visibilidad en sistemas generativos.
Se compone de cinco capas encadenadas Recuperación, Dinámica, Autoridad, Sesiones y Equidad de entidad y su función no es medir visibilidad, sino hacer auditable la medición de visibilidad.
Garantizar que toda afirmación sobre lo que un motor generativo dice, cita o recomienda pueda reconstruirse eslabón por eslabón, con denominador declarado, verificador nombrado y criterio de falsación explícito.
RADSE no sustituye al AI Visibility Model AVM™
Lo complementa en una dimensión distinta: el AVM define qué se mide presencia, comprensión, recomendación.
RADSE define cómo se traza y se verifica esa medición a lo largo de la cadena que va desde el índice hasta la recomendación, a través del tiempo, de la autoridad y de la conversación.
El AVM mide la visibilidad; RADSE la hace trazable.
1. El problema que RADSE resuelve
1.1 La brecha entre medir y poder defender lo medido
La industria de la visibilidad generativa ha entrado en una fase de producción masiva de métricas sin un régimen equivalente de verificación.
Las herramientas comerciales reportan tasas de citación, menciones, prominencia y cobertura, pero rara vez declaran el denominador sobre el que calculan esas tasas, el verificador que determina si una cita es fiel, o el periodo durante el cual una observación sigue siendo válida.
El resultado es un ecosistema de cifras que pueden ser ciertas y, sin embargo, no ser defendibles ante un cliente, un regulador o un comité de dirección.
Esa brecha no es un problema de precisión.
Es un problema de trazabilidad: falta la cadena de custodia que permita reconstruir de dónde salió un dato, qué filtros atravesó, quién lo verificó y hasta cuándo sigue siendo válido.
Sin esa cadena, una métrica de visibilidad es una fotografía sin negativo: no se puede reimprimir, no se puede auditar, no se puede falsar.
1.2 Las cinco zonas de penumbra del AVM
El AI Visibility Model identificó cinco frentes que quedaban en caja negra y que no se resuelven con más capas de dashboard.
La distinción entre recuperable y visible.
Una cosa es que un contenido entre en el pool de candidatos; otra es que sea citado; otra distinta es que su contenido se absorba en la síntesis.
La mayoría de las herramientas miden la primera capa y presentan el resultado como si midiera la última.
La asimetría entre memoria paramétrica y recuperación aumentada.
Los pesos del modelo se actualizan lenta y discontinuamente; la recuperación aumentada se actualiza rápido pero depende de índices y políticas de freshness.
Esa asimetría explica por qué una marca puede ser «conocida» por el modelo y, no ser recuperada en una consulta concreta.
La diferencia entre optimización y explicación de la selección.
La literatura de GEO ha identificado señales que correlacionan con la citación, pero sigue siendo una descripción de correlatos, no un grafo de decisión con contrafactuales.
La caída de visibilidad multi-turno.
La mayoría de las herramientas miden solo el primer turno.
La evidencia muestra que la visibilidad cae drásticamente cuando se añaden restricciones y avanza la conversación.
La calibración por entidad.
La misma métrica no mide igual a un gigante que a una pyme, ni a una región sobrerrepresentada que a una subrepresentada.
El sesgo por entidad no es un sesgo de contenido: es una brecha de infraestructura.
RADSE nace como respuesta a esas cinco zonas de penumbra.
Cada una se convierte en una capa, y las cinco capas se encadenan en el orden en que la evidencia exige.
2. Qué es RADSE
2.1 Definición
RADSE es un marco de trazabilidad y calibración que descompone la medición de visibilidad generativa en cinco capas encadenadas, cada una con definición operativa, métricas con denominador declarado, test de falsación y dependencia explícita respecto de la capa anterior.
| Letra | Capa | Función |
| R | Recuperación y atribución | Custodia la traza índice → recuperación → selección → citación → fidelidad |
| D | Dinámica temporal | Custodia la vigencia y el decaimiento de esa traza |
| A | Autoridad y grafos de decisión | Custodia las señales que sostienen la selección |
| S | Sesiones multi-turno y longitudinales | Custodia la retención a lo largo de la conversación y del tiempo |
| E | Equidad de entidad y calibración | Custodia la calibración de todas las capas por tipo de entidad y región |
2.2 Lo que RADSE no es
No es un modelo de medición.
El modelo es el AVM. RADSE es el régimen de trazabilidad que hace auditable la medición del AVM.
No es un dashboard.
Un dashboard sin fichas operativas es una foto sin custodia.
RADSE exige que cada métrica declare su denominador, su unidad y su test de falsación antes de entrar en cualquier panel.
No es una teoría nueva.
RADSE no propone una explicación alternativa de la visibilidad generativa; propone un protocolo para verificar las explicaciones existentes.
No es un score único.
RADSE rechaza explícitamente la lógica del score universal. Su unidad de análisis es la capa, no el agregado.
2.3 El nombre como sistema de direccionamiento
RADSE no es una metáfora: es un mapa que se puede recorrer letra a letra.
Cada letra es un eje, cada eje es una capa, y cada capa puede profundizarse sin romper el acrónimo.
Cuando se trabaja en recuperación, se dice «entramos en la capa R»; cuando se mide decaimiento, «medimos D-decay»; cuando se valida un contrafactual de autoridad, «validamos A-contrafactual».
Esa regularidad no es estética: es lo que permite que el marco crezca sin perder comparabilidad entre capas y sin que cada nuevo desarrollo sea un dialecto distinto.
3. Cómo nace RADSE
3.1 De la evidencia a las capas
RADSE no parte de una teoría, sino de la evidencia acumulada en los cinco frentes que el AVM identificó como zonas de penumbra.
Cada capa se formula a partir de un hallazgo empírico que la hace necesaria.
Capa R
La crisis de atribución en sistemas generativos: en logs reales, los motores visitan aproximadamente diez páginas relevantes por consulta pero citan solo tres o cuatro.
La eficiencia de citación varía de 0,19 a 0,45 en consultas idénticas. Esa brecha no es un límite técnico: es una decisión de diseño de recuperación que debe ser trazada.
Capa D
La volatilidad de la visibilidad: marcas que dependen de plataformas de citación de Tier 2/3 experimentan una volatilidad del 40–60% mes a mes.
La vida media de una citación se mide en semanas, no en trimestres. La visibilidad no es un stock: es un flujo con dos relojes.
Capa A
La diferencia entre correlato y causa: la literatura de GEO ha identificado señales de confianza que los LLM parecen priorizar, pero no ha especificado cómo se combinan en el momento de la selección.
Sin contrafactuales, el «grafo de autoridad» es una metáfora, no un modelo.
Capa S
La caída multi-turno: el 79% de las marcas caen por debajo de 0,30 de visibilidad para el tercer prompt; un retailer que era número 1 en Google orgánico pasó de 0,92 de visibilidad en el turno 1 a 0,18 en el turno 3.
De 21 herramientas analizadas, ninguna describía medición sobre múltiples rondas de diálogo.
Capa E
La brecha de infraestructura: las organizaciones sin identificador Wikidata son efectivamente invisibles para la recuperación dependiente de grafos de conocimiento.
Los LLM producen tasas más altas de alucinación en entidades sin página de Wikipedia que en entidades con presencia en Wikipedia.
La misma métrica no mide lo mismo para un gigante que para una pyme.
3.2 El orden no es negociable
Las cinco capas no son paralelas: son una escalera donde cada eslabón habilita al siguiente y reutiliza su material.
R habilita a D: sin una cadena de custodia clara entre recuperación, citación y fidelidad, la medición de decaimiento temporal mezcla fuentes que nunca fueron citadas con fuentes que dejaron de serlo.
D habilita a A: la dinámica temporal revela qué señales de autoridad son estables y cuáles son ruido; un grafo de autoridad que no distinga entre señal persistente y señal efímera no sirve para explicar la selección.
A habilita a S: la caída multi-turno solo se puede interpretar si se sabe qué autoridad se pierde y por qué; sin el grafo, la «retención» es un número sin mecanismo.
S habilita a E: la calibración por entidad requiere datos longitudinales con usuarios reales; de lo contrario, el sesgo se mide sobre prompts sintéticos que ya están sesgados por el diseño del investigador.
Ese encadenamiento es lo que distingue a RADSE de una lista de métricas.
No se puede medir D sin haber medido R; no se puede explicar A sin haber medido D; no se puede calibrar E sin haber medido S. El orden es la arquitectura.
4. Las cinco capas de RADSE
4.1 Capa R – Recuperación y atribución R-Trace
Definición. R-Trace custodia la traza que va desde la activación de la superficie generativa hasta la fidelidad de la atribución, distinguiendo qué fue recuperable, qué fue efectivamente citado y qué se absorbió de forma verificable en la síntesis.
Objeto trazado. Una unidad de fuente: el par documento recuperado, claim generado.
La traza sigue ese par desde que el documento entra en el pool de recuperación hasta que el claim se atribuye o no a ese documento en la respuesta final.
Insumo. Ninguno. R es la capa basal de RADSE.
Producto. Un registro estructurado por consulta y por documento con campos como query_id, retrieved_doc_id, retrieved_rank, cited, claim_ids, faithful, verifier y timestamp. Ese registro es el insumo de D-Drift.
Métricas nucleares:
| Métrica | Fórmula | Denominador | Unidad |
| R1 — Tasa de Citación | documentos citados / documentos recuperados | documentos en el pool de recuperación | proporción (0–1) |
| R2 — Tasa de Fidelidad | citas fieles / citas totales | citas totales en el panel de fuentes | proporción (0–1) |
| R3 — Tasa de Fuente Inventada | fuentes inventadas / fuentes citadas | fuentes citadas en la respuesta | proporción (0–1) |
| R4 — Cobertura de Claims | claims con al menos una cita / claims totales | claims totales de la respuesta | proporción (0–1) |
Test de falsación. Ablación de fuente: para cada par (documento, claim) donde cited = true y faithful = faithful, repetir la consulta eliminando el documento del contexto de recuperación.
Si el claim persiste idéntico en >80% de los casos, la citación era decorativa y R2 está midiendo algo distinto de lo que declara.
Ese resultado obligaría a revisar la definición de fidelidad de la capa R.
Dependencia rota. Si R falla, D mide decaimiento de citas que quizá nunca fueron citas reales; D-VRR hereda un denominador inconsistente; y A construye un grafo sobre citas decorativas, no sobre selecciones reales.
4.2 Capa D – Dinámica temporal D-Drift
Definición. D-Drift custodia la vigencia y el decaimiento de la traza R, sustituyendo la fotografía por la serie temporal y distinguiendo la asimetría entre memoria paramétrica y recuperación aumentada.
Objeto trazado. La serie temporal de la traza R: cómo evoluciona la citación, la fidelidad y la cobertura a lo largo del tiempo.
Insumo. El registro estructurado de R campos de §4.1
Producto. Una curva de supervivencia de visibilidad, una tasa de retención VRR y una tasa de decaimiento Citation Decay Rate, con intervalos de confianza derivados de auditorías Monte Carlo.
Métricas nucleares:
| Métrica | Fórmula | Denominador | Unidad |
| D1 — VRR (Visibility Retention Rate) | visibilidad en t+n / visibilidad en t | visibilidad en t | proporción (0–1) |
| D2 — Citation Decay Rate | (citaciones en t − citaciones en t+n) / citaciones en t | citaciones en t | tasa por periodo |
| D3 — Vida media | tiempo hasta que VRR = 0,5 | — | días/semanas |
| D4 — Desviación Monte Carlo | desviación estándar de VRR en n simulaciones | n simulaciones | proporción |
Test de falsación. Si un modelo de decaimiento estimado sobre los primeros 30 días no mejora la predicción de la visibilidad a 90 días frente a una línea base ingenua, el modelo no ha capturado el mecanismo.
La capa D se falsa cuando su capacidad predictiva no supera la de un random walk.
Dependencia rota. Sin R, D mide decaimiento de citas no verificadas; sin D, A construye un grafo sobre señales efímeras y ruido.
4.3 Capa A – Autoridad y grafos de decisión A-Graph
Definición. A-Graph custodia las señales que sostienen la selección observada en D, pasando de la optimización a la explicación de la selección mediante contrafactuales.
Objeto trazado. El grafo de corroboración de la entidad: cuántas fuentes independientes la respaldan, con qué consistencia, en qué idiomas y con qué proximidad al nodo de la consulta.
Insumo. La serie temporal de D más los metadatos de fuente de R.
Producto. Un grafo ponderado de autoridad con contrafactuales: si se añade una fuente de corroboración independiente, ¿aumenta la probabilidad de selección? ¿En cuánto? ¿Con qué latencia?
Métricas nucleares:
| Métrica | Fórmula | Denominador | Unidad |
| A1 — Corroboración | fuentes independientes que respaldan la entidad / fuentes totales | fuentes totales | proporción (0–1) |
| A2 — Contrafactual | Δ probabilidad de selección al añadir fuente / probabilidad basal | probabilidad basal | delta (0–1) |
| A3 — Latencia de autoridad | tiempo hasta que una nueva fuente afecta la selección | — | días |
| A4 — Consistencia entre motores | acuerdo de selección entre motores / selecciones totales | selecciones totales | proporción (0–1) |
Test de falsación. Si añadir una fuente de corroboración independiente no cambia la probabilidad de selección en un experimento controlado, el grafo de autoridad no ha capturado el mecanismo.
La capa A se falsa cuando sus contrafactuales no producen cambios medibles.
Dependencia rota. Sin D, A construye un grafo sobre señales efímeras y ruido; sin A, S mide «retención» sin mecanismo de autoridad.
4.4 Capa S – Sesiones multi-turno y longitudinales S-Retention
Definición. S-Retention custodia la retención de la traza a lo largo de turnos y sesiones, sustituyendo el primer turno por la curva de supervivencia conversacional.
Objeto trazado. La trayectoria de la entidad en la conversación: cómo cambia su visibilidad cuando se añaden restricciones precio, normativa, contexto local y cuando avanza la sesión.
Insumo. El grafo de autoridad de A más los logs de sesión reales o simulados con protocolo declarado.
Producto. Una curva de retención por turno turno 1, 3, 6 con grupo de control, y una distinción entre deriva de intención, colapso de consenso y sustitución competitiva.
Métricas nucleares:
| Métrica | Fórmula | Denominador | Unidad |
| S1 — Retención en turno n | visibilidad en turno n / visibilidad en turno 1 | visibilidad en turno 1 | proporción (0–1) |
| S2 — Tasa de colapso | entidades que desaparecen en turno 3 / entidades en turno 1 | entidades en turno 1 | proporción (0–1) |
| S3 — Sustitución competitiva | entidades nuevas en turno n / entidades en turno n | entidades en turno n | proporción (0–1) |
| S4 — Efecto de restricción | Δ visibilidad al añadir restricción / visibilidad sin restricción | visibilidad sin restricción | delta |
Test de falsación. Si la retención en turno 3 no difiere entre condición de conversación libre y condición guiada, el mecanismo de caída no es la restricción sino otra cosa, y S está midiendo un artefacto del diseño.
La capa S se falsa cuando su grupo de control no produce diferencias.
Dependencia rota. Sin A, S mide retención sin mecanismo de autoridad; sin S, E mide sesgo sobre prompts sintéticos ya sesgados por el diseño del investigador.
4.5 Capa E – Equidad de entidad y calibración E-Calibration
Definición. E-Calibration custodia la calibración de todas las capas por tipo de entidad y región, separando los perfiles de fallo que las capas anteriores no distinguen.
Objeto trazado. El perfil de fallo de la entidad: invisibilidad por citación, invisibilidad por recuperación, invisibilidad por infraestructura y paradoja de la alucinación de marca.
Insumo. Las salidas de R, D, A y S, estratificadas por entidad QID, NER, lengua, región.
Producto. Un mapa de error por entidad y una calibración que permita comparar entidades de distinto tipo sin aplicar un score universal.
Métricas nucleares:
| Métrica | Fórmula | Denominador | Unidad |
| E1 — Presencia en grafo | entidades con QID / entidades evaluadas | entidades evaluadas | proporción (0–1) |
| E2 — Consistencia NER | menciones correctamente linkeadas / menciones totales | menciones totales | proporción (0–1) |
| E3 — Tasa de alucinación por entidad | claims falsos sobre la entidad / claims totales sobre la entidad | claims totales | proporción (0–1) |
| E4 — Brecha de calibración | error de predicción con métrica agregada − error con calibración por entidad | error agregado | delta |
Test de falsación. Si la calibración por entidad no mejora la predicción de visibilidad frente a una métrica agregada, el sesgo es un residuo no explicado, no un objeto de medición.
La capa E se falsa cuando su calibración no supera a la métrica ingenua
Dependencia rota. Sin S, E mide sesgo sobre prompts sintéticos ya sesgados; sin E, RADSE produce métricas que no son comparables entre tipos de entidad.
5. El encadenamiento como arquitectura
5.1 La escalera de dependencias
RADSE no es una colección de cinco métricas: es una escalera donde cada eslabón habilita al siguiente.
La regla es que cada capa consume el output de la anterior y lo convierte en insumo verificable de la siguiente:
R (traza cruda) → D (vigencia) → A (explicación) → S (ecología) → E (calibración)
Si se rompe un eslabón, los posteriores quedan contaminados.
Una custodia temporal sin custodia de fuente mide decaimiento de citas que quizá nunca fueron citas reales.
Un grafo de autoridad sin dinámica temporal explica selecciones sobre señales que ya no existen.
Una curva de retención sin grafo de autoridad mide caída sin mecanismo.
Una calibración por entidad sin datos longitudinales mide sesgo sobre prompts sintéticos.
5.2 Por qué el orden no se puede invertir
La tentación operativa es empezar por E equidad porque es el eje con mayor carga normativa, o por S sesiones porque es el más visible en dashboards.
RADSE rechaza ese orden por una razón metodológica: E necesita datos longitudinales reales de S; S necesita el grafo de autoridad de A; A necesita la serie temporal de D; D necesita la traza de R. Invertir el orden produce métricas que parecen medir lo que declaran pero miden otra cosa.
5.3 La matriz de dependencias
| Capa | Consume | Produce | Si falla, contamina a |
| R | — | Traza de fuente | D, A, S, E |
| D | R | Curva de supervivencia | A, S, E |
| A | D + metadatos R | Grafo de corroboración | S, E |
| S | A + logs de sesión | Curva de retención | E |
| E | R, D, A, S estratificados | Mapa de error | — |
6. Qué aporta RADSE al proyecto global
6.1 Trazabilidad causal
Convierte una métrica de visibilidad en una cadena de custodia verificable: qué se recuperó, qué se citó, con qué fidelidad, durante cuánto tiempo, por qué se seleccionó, en qué turno sobrevivió y para qué tipo de entidad.
Sin esa cadena, un score es una fotografía; con RADSE, es un registro auditable.
6.2 Gobernanza operativa
Permite declarar qué eslabón está roto cuando una afirmación no es defendible.
Un dashboard puede decir «visibilidad 0,72»; RADSE debe poder decir qué capa sostiene ese 0,72 y cuál falla.
Eso es lo que separa un instrumento de un adorno.
6.3 Falsabilidad
Cada capa incorpora un test de falsación explícito.
Sin test, una capa no entra en RADSE.
Esa exigencia es lo que distingue un marco de una lista de deseos.
6.4 Escalabilidad regular
Las cinco capas comparten estructura idéntica: definición, tres preguntas, objeto trazado, insumo, producto, métricas con denominador, test de falsación y dependencia rota.
Esa regularidad permite que el marco crezca sin perder comparabilidad.
6.5 Calibración equitativa
La capa E no es un apéndice ético: es una condición metrológica.
Sin calibración por entidad, la misma métrica no mide lo mismo para un gigante que para una pyme, y el «sesgo» se convierte en un residuo no explicado.
7. Cómo encaja RADSE en la arquitectura del proyecto
7.1 Tres niveles
| Nivel | Componente | Función |
| Modelo | AVM™ | Define qué se mide: presencia, comprensión, recomendación |
| Marco | RADSE | Define cómo se traza y se verifica esa medición, capa por capa |
| Protocolo | Documento Cero RADSE | Convierte cada capa en ficha operativa con fórmulas, denominadores y tests |
El encaje es secuencial, no paralelo.
El AVM fija las dimensiones; RADSE las descompone en eslabones verificables; el Documento Cero las convierte en instrumento.
Sin el AVM, RADSE no tendría qué trazar; sin RADSE, el AVM no tendría cómo defenderse; sin el Documento Cero, RADSE sería un mapa sin brújula.
7.2 Retroalimentación bidireccional
RADSE recibe del AVM las dimensiones que debe custodiar y devuelve al AVM cinco capacidades que el modelo no tenía:
Trazabilidad causal (R): la distinción entre recuperable, citado y absorbido.
Dinámica gobernable (D): la sustitución de la fotografía por la serie temporal.
Explicación de selección (A): el paso de la optimización al contrafactual.
Validez ecológica (S): la medición en conversaciones reales, no en prompts aislados.
Calibración equitativa (E): la comparabilidad entre tipos de entidad y regiones.
Con esas cinco capacidades, el AVM deja de ser un marco descriptivo y pasa a ser un modelo predictivo y falsable.
7.3 Lo que RADSE no cambia del AVM
RADSE no rebautiza el AVM ni sustituye sus dimensiones.
Mantiene la separación entre modelo qué se mide y marco cómo se traza.
Esa separación es deliberada: permite que el AVM evolucione sin que RADSE se rompa, y que RADSE se profundice sin que el AVM pierda su identidad.
8. El Documento Cero: de marco a instrumento
8.1 Qué es
El Documento Cero es la pieza que convierte RADSE en instrumento operativo.
No es un paper: es un documento de trabajo de 5–8 páginas, una ficha por letra, con estructura idéntica.
Si las cinco fichas no son comparables entre sí, RADSE no escala.
8.2 Estructura fija de cada ficha
Definición de una línea – qué custodia o traza esa capa.
Pregunta de tres niveles – ¿dónde estamos? / ¿a dónde queremos llegar? / ¿cómo sabemos que llegamos?
Objeto trazado – qué se sigue (una URL, una entidad, una sesión, una cita).
Insumo – qué output de la capa anterior consume.
Producto – qué entrega a la capa siguiente (formato de dato, no prosa).
Métricas nucleares – 3–5 como máximo, cada una con fórmula, denominador y unidad.
Test de falsación – qué resultado obligaría a revisar la capa.
Dependencia rota – qué se contamina si esta capa falla.
8.3 Regla de oro
Ninguna métrica entra en RADSE si no declara su denominador.
«Tasa de citación» sin denominador ¿sobre recuperadas? ¿sobre consultas? ¿sobre turnos? no es métrica, es eslogan.
8.4 Orden de ejecución
| Semana | Acción | Entregable |
| 1 | Ficha R completa | R-Trace operativo |
| 2 | Ficha D completa | D-Drift operativo (consume R) |
| 3 | Ficha A completa | A-Graph operativo (consume D) |
| 4 | Ficha S completa | S-Retention operativo (consume A) |
| 5 | Ficha E completa | E-Calibration operativo (consume S) |
| 6 | Glosario + matriz de dependencias | Documento Cero v1.0 |
La razón del orden es la misma que la del encadenamiento: cada ficha solo puede escribirse cuando la anterior está cerrada, porque su insumo es el producto de la anterior.
Si se escriben en paralelo, se duplican métricas y se rompe la arquitectura.
8.5 Criterio de éxito
El Documento Cero está terminado cuando puedes responder, para cada una de las cinco letras, estas tres preguntas sin ambigüedad:
¿Qué dato produce esta capa que la anterior no producía?
¿Cuál es su denominador y su unidad?
¿Qué resultado la falaría?
Si alguna ficha no responde las tres, RADSE todavía no es operativo: es un mapa bonito.
9. Riesgos y salvaguardas
9.1 Riesgo de circularidad
Medir la visibilidad con los mismos prompts que se usan para optimizarla.
La literatura sobre GEO advierte que las mediciones son altamente variables entre repeticiones, y esa variabilidad es especialmente severa para entidades subrepresentadas, cuyas lecturas de visibilidad son inestables y a menudo cero.
Salvaguarda: repetición con control de confounders y declaración del número de repeticiones en cada métrica.
9.2 Riesgo de verificación
La fidelidad de citación depende del verificador; sin un protocolo anclado a oro humano, las tasas de «citas no soportadas» no son comparables.
Salvaguarda: todo verificador debe declararse humano anotado, LLM-juez con prompt y temperatura, o híbrido y acompañarse de un kappa objetivo ≥0,70 cuando sea humano.
9.3 Riesgo de extrapolación
Los datos de decaimiento y de caída multi-turno provienen de contextos y fechas específicas; la vida media de una citación no es una constante universal, sino una propiedad del motor, del dominio y del ciclo de actualización.
Salvaguarda: reportar intervalos de confianza y no convertir una observación local en una ley general.
9.4 Riesgo de fragmentación
Que cada capa se desarrolle como un dialecto distinto y se pierda la comparabilidad entre capas.
Salvaguarda: estructura idéntica de ficha para las cinco capas y glosario consolidado en el Documento Cero.
Conclusión
RADSE no es un modelo más de visibilidad generativa.
Es el régimen de trazabilidad que hace que los modelos de visibilidad sean auditables.
Su aportación no es una métrica nueva, sino una disciplina: la de declarar el denominador, nombrar el verificador, fechar la observación y falsar la capa.
Esa disciplina es lo que separa una cifra de un instrumento.
El AVM mide la visibilidad; RADSE la hace trazable.
Cinco capas, cinco letras: R de recuperación, D de dinámica, A de autoridad, S de sesiones, E de equidad de entidad.
Sin una capa, la medición no es auditable. Con las cinco, la visibilidad deja de ser una fotografía y se convierte en una cadena de custodia con reloj, grafo, conversación y calibración por entidad.
Anexo: glosario mínimo
| Término | Definición |
| RADSE | Marco de trazabilidad y calibración de visibilidad generativa en cinco capas encadenadas |
| R-Trace | Capa de recuperación y atribución: traza índice → recuperación → selección → citación → fidelidad |
| D-Drift | Capa de dinámica temporal: vigencia y decaimiento de la traza R |
| A-Graph | Capa de autoridad y grafos de decisión: señales que sostienen la selección |
| S-Retention | Capa de sesiones multi-turno: retención a lo largo de la conversación |
| E-Calibration | Capa de equidad de entidad: calibración por tipo de entidad y región |
| Documento Cero | Protocolo operativo que convierte cada capa en ficha con fórmulas, denominadores y tests |
| VRR | Visibility Retention Rate: visibilidad en t+n sobre visibilidad en t |
| Citation Decay Rate | Tasa de decaimiento de citaciones por periodo |
| Ablación de fuente | Test de falsación de R: eliminar la fuente y medir si el claim cambia |
| Perfil de fallo | Clasificación de la invisibilidad: por citación, por recuperación, por infraestructura o por alucinación |
| Denominador declarado | Regla de oro de RADSE: ninguna métrica entra sin declarar sobre qué se calcula |
Documento de presentación formal de RADSE. Versión 1.0. Para el desarrollo operativo, véase el Documento Cero RADSE.